服务器机房出现异常怎么办
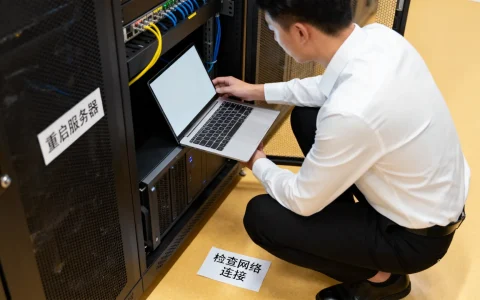
服务器机房出现异常时,应立即启动分级响应机制:切断潜在风险源,保障核心业务运行;快速定位故障点(电力、制冷、网络或硬件);执行标准化应急预案(如切换备用系统、隔离故障设备);在确保业务稳定的前提下进行根因分析与修复;事后必须复盘并优化监控及容灾体系。

核心原则:分级响应,先保业务
-
一级响应:切断风险,保住核心
- 物理安全优先: 若存在烟雾、火光、异响、液体泄漏等直接物理风险,立即按标准流程切断总电源(需确认不影响消防系统),疏散人员,启动消防预案,并通知消防部门。
- 核心业务保障: 无直接物理风险时,首要目标是维持最关键业务在线,启动备用链路(如4G/5G无线网络),将核心业务流量切换至灾备中心(如有),若无法切换,优先保障核心服务器供电与网络。
-
二级响应:精准定位故障源
- 全面采集信息:
- 监控系统: 查看动环监控(温湿度、水浸、烟感、门禁)、电力监控(输入电压/电流、UPS状态、电池参数、PDU负载)、制冷监控(精密空调运行状态、送/回风温度、冷媒压力)、网络监控(设备状态、端口流量、丢包率、延迟)、服务器/存储硬件监控(健康状况、日志告警)。
- 人员反馈: 迅速询问现场人员观察到的具体现象(异响位置、设备指示灯状态、报警声类型、异常气味来源)。
- 日志分析: 集中收集并分析关键设备(路由器、核心交换机、防火墙、服务器、存储、虚拟化管理平台)的系统日志、事件日志、应用日志,使用ELK Stack、Splunk等工具加速检索关键错误信息。
- 故障域隔离:
- 缩小范围: 基于信息判断是局部故障(单机柜、单台UPS、单台空调)还是全局故障(市电中断、核心网络中断、制冷全停)。
- 关键测试: 进行有针对性测试(如ping测试、端口状态检查、服务端口telnet测试、设备重启)时,需评估风险,避免故障扩大。
- 全面采集信息:
应急处理:快速止血,恢复服务
-
电力故障:
- 市电中断: 确认UPS正常接管负载,评估电池续航时间,关闭非必要设备,优先保障核心设备运行,若续航不足,按流程安全关机,启用备用发电机(如有)。
- UPS故障: 立即将负载切换至冗余UPS系统或备用线路,无冗余时,评估市电稳定性,若稳定可尝试旁路运行(风险高,需谨慎),单台UPS模块故障,热插拔更换。
- PDU/配电柜故障: 切换至备用回路,检查断路器是否跳闸,排查短路后尝试复位(仅限一次)。
-
制冷故障:
- 空调停机: 启动备用空调,无冗余时,打开机柜门(仅应急),调大风量,增加临时风扇(注意气流组织),关闭高密度非核心设备,严密监控温度,超过阈值(如30°C)需按预案关闭部分设备。
- 冷媒泄漏/水路故障: 隔离故障机组,启用备用系统,应急通风降温同上。
- 升温过快处理: 除上述措施,可考虑在夜间低温时段引入室外冷空气(需严格过滤)。
-
网络故障:
- 核心设备宕机: 切换至冗余设备,检查电源、模块状态,重启无效需硬件更换。
- 链路中断: 切换备用物理线路或启用运营商冗余链路(如BGP智能切换),检查光衰、端口状态、配置。
- 流量异常/攻击: 在边界设备(防火墙/IPS)启用应急预案,隔离攻击源IP或网段,限流,清洗流量。
-
硬件故障(服务器/存储):
- 单机故障: 业务若已集群化/负载均衡,自动或手动切换流量至健康节点,维修或更换故障部件(硬盘、电源、内存、RAID卡)。
- 存储故障: 切换至备用存储阵列,检查控制器状态、磁盘组状态、链路状态,更换故障磁盘,触发RAID重构(注意性能影响)。
- 关键单点故障: 若无冗余,优先尝试修复,修复失败,启用备份恢复至备用设备(时间较长)。
恢复与验证:稳健操作,确认效果
- 有序恢复:
- 在确认故障根本解决且环境稳定后,按先关键后次要、先基础服务后上层应用的原则恢复受影响系统。
- 密切监控恢复过程中的资源占用、性能指标和日志报错。
- 全面验证:
- 功能验证: 测试所有关键业务功能是否正常可用。
- 性能验证: 检查系统响应时间、吞吐量是否恢复到正常基线水平。
- 数据验证: 确认数据库一致性、应用数据完整性无异常。
- 监控确认: 确保所有监控项恢复正常状态,无残留告警。
根因分析与根本解决
- 深入调查: 组建包含基础设施、网络、系统、应用专家的团队,彻底分析故障产生的技术原因和管理原因(如配置错误、流程缺陷、预警失效、供应商问题)。
- 撰写报告: 详细记录时间线、现象、处置过程、根因、影响范围、经验教训。
- 制定方案: 针对根因,制定并执行有效的改进措施(如硬件更换、配置加固、架构优化、流程修订、供应商管理、演练加强)。
构建韧性:预防胜于救灾
- 基础设施加固:
- 电力: 双路市电+ATS,N+X冗余UPS(定期负载测试与电池检测),柴油发电机(带自启动及油料保障),STS静态切换开关。
- 制冷: N+1或2N冗余精密空调,合理气流组织(冷热通道密封),温度/湿度实时监控与动态调整。
- 物理环境: 高灵敏度漏水检测、烟雾探测、视频监控、门禁管理、抗震加固。
- 架构高可用:
- 网络: 核心设备堆叠/虚拟化,关键链路多物理路径冗余,BGP多出口。
- 计算: 服务器集群(Failover Cluster, VMware HA)、负载均衡。
- 存储: 双活/主备存储,同步/异步复制,快照技术。
- 应用: 无状态设计、微服务化、容器化部署。
- 监控与预警体系:
- 全覆盖: 动环、网络、系统(OS/虚拟机)、应用、业务指标全方位监控。
- 智能化: 利用AIops进行异常检测、趋势预测、告警降噪、根因分析。
- 多通道告警: 短信、电话、邮件、钉钉/企业微信集成,确保关键告警必达,设置不同级别告警阈值和升级策略。
- 完备的应急体系:
- 预案库: 针对各类常见及重大故障场景(如全站断电、核心网络中断、空调全停、火灾)制定详细、可操作的应急预案(SOP),明确RTO/RPO。
- 演练: 定期(至少每季度)进行桌面推演和实战演练,验证预案有效性,提升团队协同能力。
- 容灾备份: 建立同城/异地容灾中心,确保重要数据实时/准实时复制,执行严格的备份策略(全备+增量/差异)并定期验证备份可恢复性。
- 精细化管理与团队建设:
- 配置管理: 建立CMDB,严格管理变更流程(变更窗口、审批、回滚方案)。
- 容量管理: 定期评估并预测电力、制冷、空间、网络带宽、计算/存储资源需求。
- 供应商管理: 明确SLA,建立关键设备备件库,确保维保服务及时有效。
- 人员培训: 持续进行技术培训、安全意识培训、应急响应流程培训,培养专家型运维团队。
机房稳定无小事,每一次异常都是对防御体系的压力测试,完善的监控如同敏锐的神经,冗余架构是坚实的骨骼,而清晰的应急预案则是条件反射般的肌肉记忆,当故障突袭,是选择在混沌中手忙脚乱,还是凭借体系化的防御从容应对?关键在于日常是否将韧性思维渗透到每个机柜、每条线路。
贵公司的核心业务,是否拥有经受住真实故障考验的恢复能力?欢迎分享您在机房运维中遇到的关键挑战或成功经验,如需深度机房巡检清单或高可用架构评估框架,可私信获取。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/29047.html