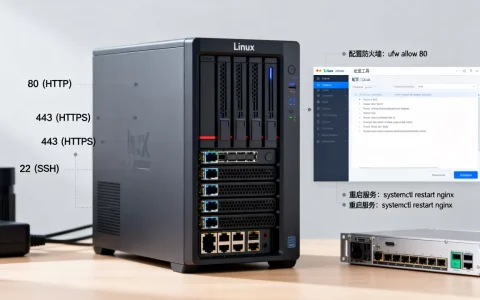
服务器查看信息吗?答案是完全可以,并且是服务器管理和维护的核心工作之一,掌握有效查看服务器信息的方法,对于保障系统稳定运行、优化性能、快速排查故障以及进行容量规划至关重要。
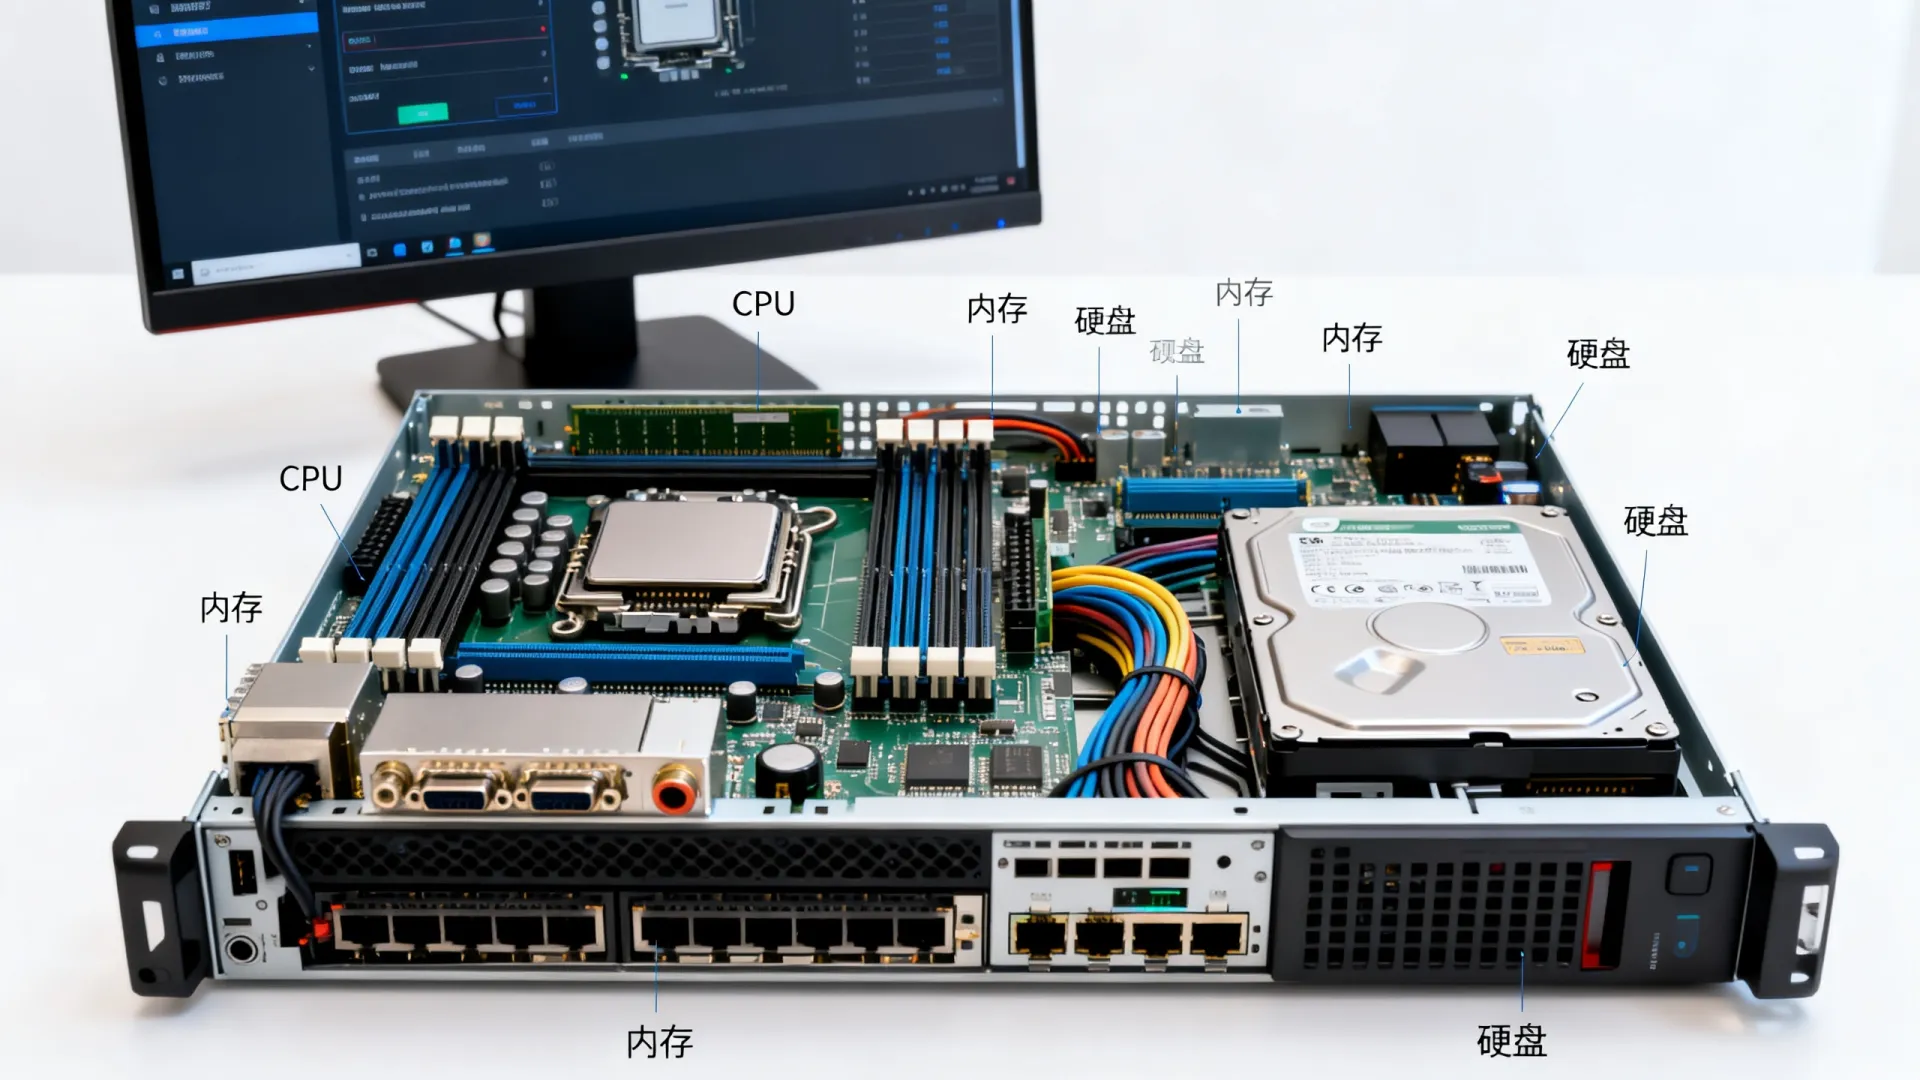
服务器就像数字世界的心脏,其内部状态硬件配置、资源使用情况、运行的服务、网络连接、安全日志等时刻都在变化,管理员需要像医生使用听诊器和检查仪器一样,熟练运用各种工具来“查看”这些信息,从而诊断服务器的“健康”状况。
基础探针:命令行工具的力量
对于Linux/Unix服务器,命令行终端是获取信息的直接窗口,掌握以下核心命令是基本功:
-
系统概览与资源监控:
top/htop:实时动态查看CPU、内存(Mem & Swap)、进程负载情况。htop提供更友好的交互界面和色彩标记。free -h:清晰显示内存(物理内存、Swap交换空间)的总量、已用、空闲和缓存/缓冲使用情况(-h参数以人类可读格式显示)。df -h:查看磁盘分区挂载点、总空间、已用空间、可用空间及使用百分比(-h参数同样用于易读格式)。uptime:快速查看系统运行时间、当前登录用户数和过去1、5、15分钟的系统平均负载。vmstat [间隔] [次数]:报告虚拟内存统计信息,包括进程、内存、分页、块IO、陷阱和CPU活动,常用于分析性能瓶颈。iostat [间隔] [次数]:监控系统输入/输出设备负载情况,提供CPU利用率、设备吞吐量、IO等待等信息,对磁盘性能分析尤其重要。netstat/ss:查看网络连接(TCP/UDP)、路由表、网络接口(Network Interface)统计信息。ss是netstat的现代替代品,速度更快。ifconfig/ip addr:查看和配置网络接口信息(IP地址、MAC地址、状态、流量统计)。ip命令更强大且是未来趋势。lscpu:详细显示CPU架构信息(型号、核心数、线程数、缓存大小、频率等)。lsblk:列出所有可用块设备(硬盘、分区)的信息。lshw:列出详细的硬件配置信息(需要root权限)。
-
进程与服务洞察:
ps aux:列出当前所有运行进程的详细信息(用户、PID、CPU%、内存%、启动时间、命令等)。systemctl status [服务名]:查看特定系统服务(如nginx, mysql, sshd)的运行状态、日志片段和是否启用开机启动。journalctl:查询和查看systemd管理的系统日志,结合-u [服务名]可查看特定服务的日志,--since/--until指定时间范围,-f实时跟踪。
-
硬件深度检测:
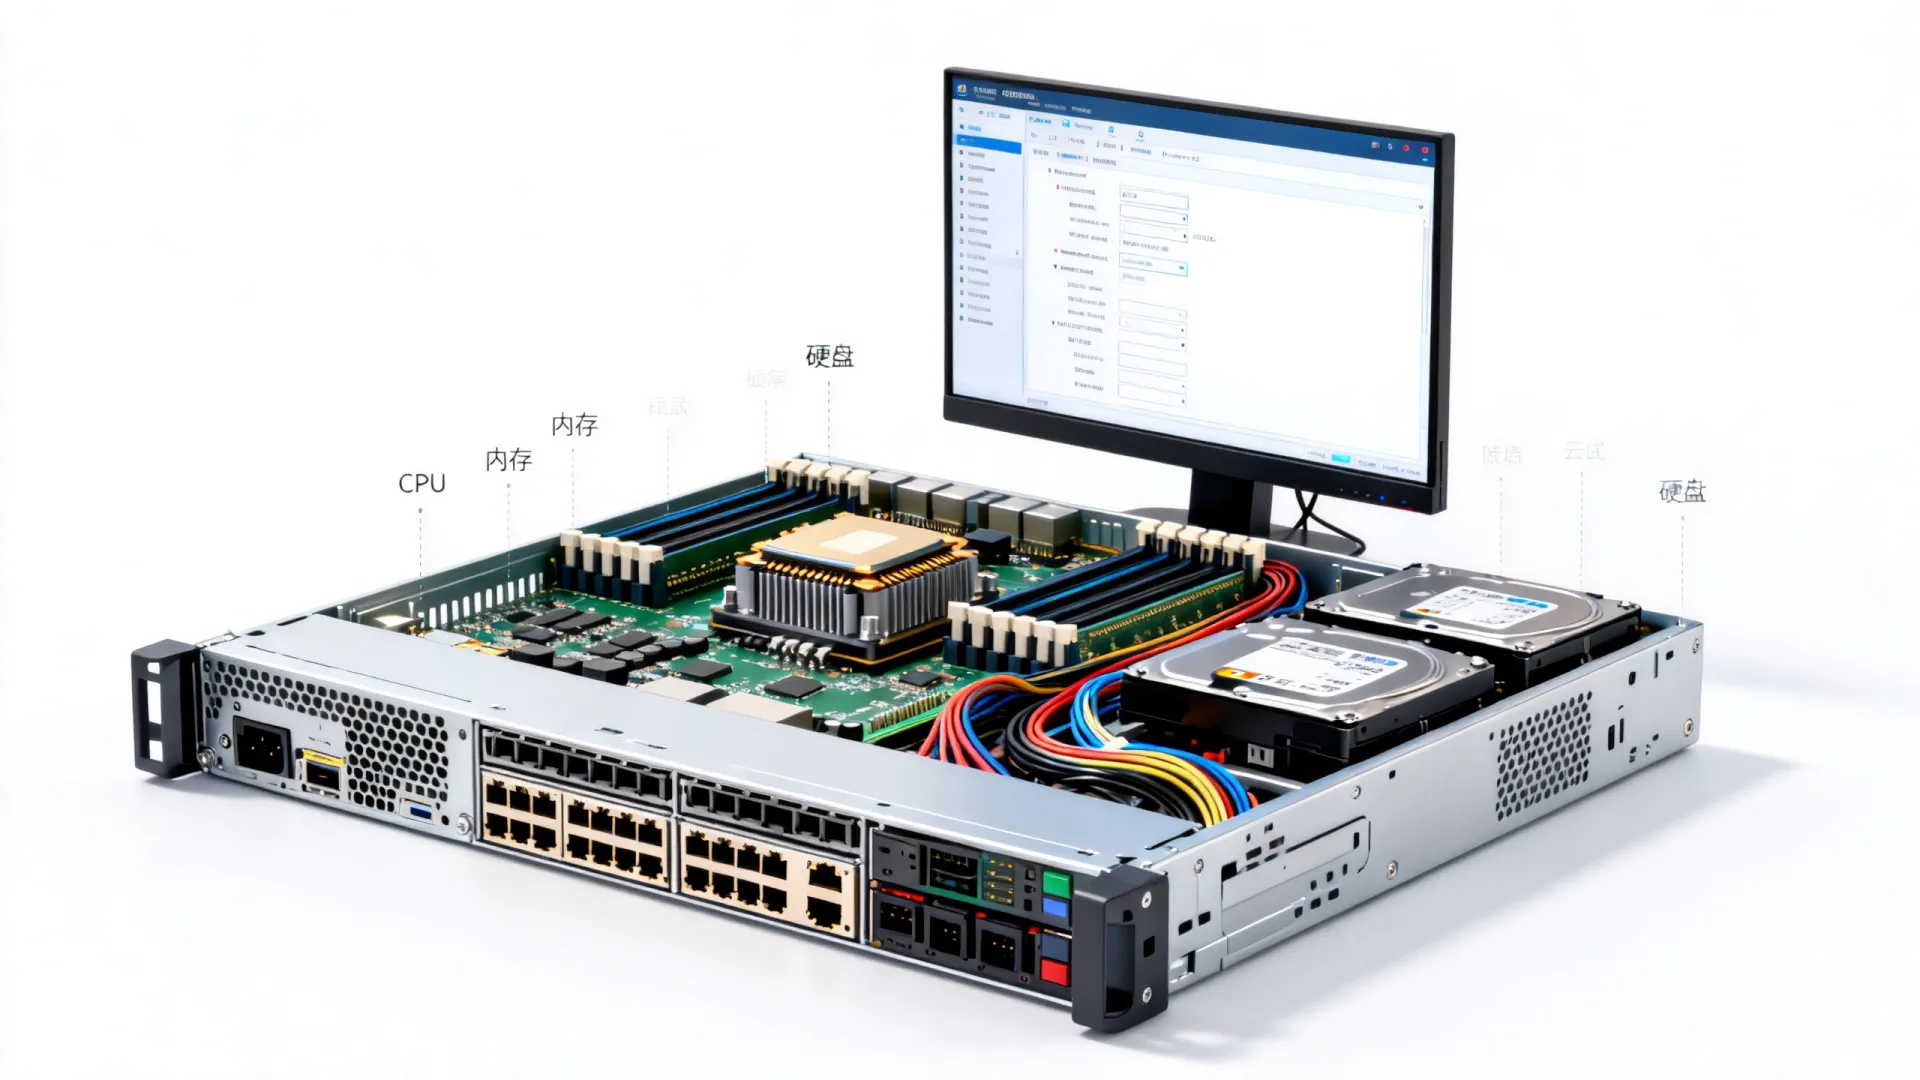
dmidecode:直接从DMI (SMBIOS)表中读取详细的硬件信息,包括主板、BIOS、处理器、内存条(型号、大小、速度)、系统序列号等(需要root权限)。smartctl -a /dev/sdX:获取指定硬盘(如/dev/sda)的S.M.A.R.T. (自监测、分析和报告技术) 健康信息,预测硬盘潜在故障。
全局视野:系统监控与仪表盘
命令行工具虽强大,但难以提供历史趋势和全局视图,专业的系统监控解决方案是生产环境不可或缺的:
-
经典开源方案:
- Nagios / Icinga: 老牌监控系统,专注于服务可用性和告警,通过插件监控几乎任何指标,配置灵活但相对复杂。
- Zabbix: 功能全面的企业级监控平台,支持自动发现、分布式监控、强大的告警机制、丰富的可视化图表和模板,适合复杂环境。
- Prometheus + Grafana: 现代云原生监控的标杆。
- Prometheus: 专注于时间序列数据的采集、存储和查询,采用拉取(Pull)模型,特别适合动态环境(如Kubernetes)。
- Grafana: 强大的可视化仪表盘工具,数据源支持广泛(包括Prometheus),能创建直观、美观的图表进行性能分析和趋势观察。
- ELK Stack (Elasticsearch, Logstash, Kibana) / EFK Stack (Fluentd替代Logstash): 强大的日志集中管理、分析和可视化方案。
Filebeat等轻量级日志采集器将服务器日志发送到中心存储(Elasticsearch),通过Kibana进行搜索、分析和创建仪表盘,是查看和分析服务器运行日志、应用日志、安全日志的核心工具。
-
商业与云服务方案:
- Datadog, New Relic, Dynatrace: SaaS化的全栈可观测性平台(APM + Infrastructure + Logs + Synthetics),功能强大,开箱即用,集成度高,但成本较高,提供深入的应用性能洞察和基础设施监控。
- 云服务商原生监控: AWS CloudWatch, Azure Monitor, Google Cloud Operations (原Stackdriver),深度集成各自云平台服务,提供资源监控、日志管理、告警等功能,是云服务器监控的首选起点。
信息解读与决策:不止于查看
仅仅“看到”信息是不够的,关键在于理解、分析并采取行动:
- 建立基线: 在系统正常运行期间记录关键指标(CPU、内存、磁盘IO、网络流量)的正常范围,这是判断异常的基准。
- 设置智能告警: 不要淹没在信息海洋中,基于基线或业务需求,在监控系统中设置合理的阈值告警(如CPU持续>90%超过5分钟,磁盘空间不足80%),告警应明确、可操作,避免“狼来了”。
- 关联分析: 单一指标异常往往不足以定位问题根源,应用响应慢可能由数据库慢查询、磁盘IO瓶颈、网络延迟或应用自身Bug引起,需要结合CPU、内存、IO、网络、应用日志、数据库日志等信息进行关联分析。
- 趋势预测与容量规划: 利用历史数据预测未来的资源需求(如磁盘空间增长趋势、访问量增长带来的CPU/内存压力),提前规划扩容或优化,避免资源耗尽导致的故障。
- 安全审计: 定期查看系统日志(特别是认证日志
/var/log/auth.log或/var/log/secure)、安全工具(如fail2ban)日志、网络连接情况,及时发现异常登录尝试、可疑进程或未授权访问。
我们的独立见解:将“查看”升级为“洞察”与“自动化”
在当今复杂的IT环境中,仅仅被动地“查看”服务器信息已显不足,我们建议将重点转向:
- 构建统一可观测性平台: 整合Metrics(指标)、Logs(日志)、Traces(链路追踪)数据,打破监控孤岛,这提供了理解系统行为(从用户请求到后端服务调用)的完整上下文,极大提升故障诊断效率,Prometheus + Loki + Tempo + Grafana (或类似组合)是实现此目标的开源利器。
- 拥抱AIOps理念: 利用机器学习和人工智能算法,从海量监控数据中自动识别异常模式、预测潜在故障、进行根因分析,减少人工排查时间,许多商业监控平台已开始集成AIOps功能。
- 自动化响应: 将监控与自动化运维(如Ansible, SaltStack, Terraform)结合,当检测到磁盘空间即将耗尽时,自动触发清理脚本或扩容流程;当服务健康检查失败时,自动重启服务或进行故障转移。
- 关注应用性能指标(APM): 服务器基础设施健康是基础,但最终目标是保障应用流畅运行,集成APM工具(如开源的SkyWalking、Pinpoint,或商业产品)监控应用代码级别的性能瓶颈、错误率和用户体验至关重要。
信息即力量
查看服务器信息是服务器管理的基石,从基础命令到现代化监控与可观测性平台,管理员拥有强大的工具集来透视服务器的每一个角落。真正的专业价值不仅在于获取信息,更在于如何解读这些信息,将其转化为保障系统稳定性、提升性能、强化安全性和优化成本的有效决策与自动化行动。 持续学习和应用新的监控理念与工具,是每一位负责任的服务器管理员保持专业权威和可信度的关键。
您目前在监控服务器信息时,遇到的最大挑战或最希望改进的方面是什么?是告警噪音、根因定位困难,还是缺乏统一的可视化视图?欢迎分享您的经验和见解。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/28554.html