归一化处理严格意义上不属于图像增强,它属于图像预处理步骤,旨在统一数据分布而非提升视觉质量。
在计算机视觉和深度学习的工程实践中,很多人容易混淆“增强”与“预处理”的界限,这种混淆往往源于两者都在模型训练前的数据管道中出现,从算法设计的初衷和最终效果来看,归一化是为了让模型“吃得下”数据,而图像增强是为了让模型“看得懂”更多样化的场景,理清这一区别,对于构建高效的AI训练流水线至关重要。
归一化与图像增强的本质差异
要理解为什么归一化不是增强,我们需要深入两者的核心目的,图像增强的核心在于“创造”和“丰富”,它通过几何变换、色彩调整等手段,人为地增加数据的多样性,从而防止模型过拟合,而归一化的核心在于“标准化”和“收敛”,它通过数学变换,将像素值映射到特定的区间,确保输入数据的统计特性一致。
目的不同:多样性 vs 稳定性
图像增强关注的是语义层面的丰富性,对一张猫的照片进行旋转、翻转或调整亮度,目的是告诉模型:无论猫怎么动、光线如何变化,它依然是猫,这种操作增加了训练集的等效规模,提升了模型的泛化能力。
相比之下,归一化关注的是数值层面的稳定性,神经网络的激活函数(如Sigmoid或Tanh)对输入值的范围非常敏感,如果像素值分布在0-255之间,未经处理的梯度可能会爆炸或消失,导致模型无法收敛,归一化将数据缩放到[0,1]或[-1,1]区间,是为了让梯度下降算法能够平稳、快速地找到最优解,业内专家指出,这种数值上的稳定性是模型训练成功的基石,而非视觉上的增强。
效果不同:视觉变化 vs 数值分布
图像增强通常会改变图像的外观,如果你将一张照片进行高斯模糊或添加噪声,人眼能明显感知到图像质量或内容的变化,这些变化是有意为之,旨在模拟真实世界中的干扰因素。
归一化则完全不会改变图像的视觉外观,将像素值从0-255线性映射到0-1,图像看起来依然是一模一样的照片,只是背后的数值变了,这种操作对人眼不可见,但对机器至关重要,它不增加新的信息,也不改变信息的语义,只是改变了信息的表达方式。
归一化的核心作用机制
既然归一化不增强视觉,那为什么它在图像预处理中不可或缺?答案在于优化效率,深度学习模型的训练过程本质上是一个高维空间的优化问题,而归一化能显著改善这个空间的几何结构。
加速梯度下降收敛
当输入特征的尺度差异巨大时,损失函数的等高线会变得狭长且倾斜,在这种情况下,梯度下降算法会沿着狭长的山谷来回震荡,导致收敛速度极慢,归一化通过消除特征间的量纲差异,使等高线趋向于圆形,从而让梯度下降能够直接指向最优解。
在实际操作中,常见的归一化方法包括最小-最大归一化和Z-Score标准化。
- 最小-最大归一化:将数据线性映射到[0,1]区间,公式为 $x’ = frac{x – min}{max – min}$,这种方法保留了原始数据的分布形状,但对异常值敏感。
- Z-Score标准化:将数据转换为均值为0、标准差为1的分布,公式为 $x’ = frac{x – mu}{sigma}$,这种方法对异常值的鲁棒性更强,是许多深度学习框架的默认选择。
提升模型泛化能力
虽然归一化本身不增加数据多样性,但它通过稳定训练过程,间接提升了模型的泛化能力,一个无法收敛的模型,无论数据增强做得多好,都无法学到有效的特征,归一化确保了模型能够在合理的时间内达到较好的性能基线,为后续的数据增强和模型调优奠定基础。
图像增强的典型场景与策略
与归一化不同,图像增强是真正意义上“增强”模型性能的手段,它通过引入人为的扰动,模拟真实世界中的复杂情况,迫使模型学习更具鲁棒性的特征。
几何变换
几何变换是最基础的图像增强手段,包括旋转、平移、缩放和翻转,这些操作不改变图像的语义内容,但改变了其空间结构,在自动驾驶场景中,车辆可能以不同角度出现在摄像头中,通过随机旋转和翻转训练数据,模型可以学会识别不同姿态的车辆。
色彩与光照调整
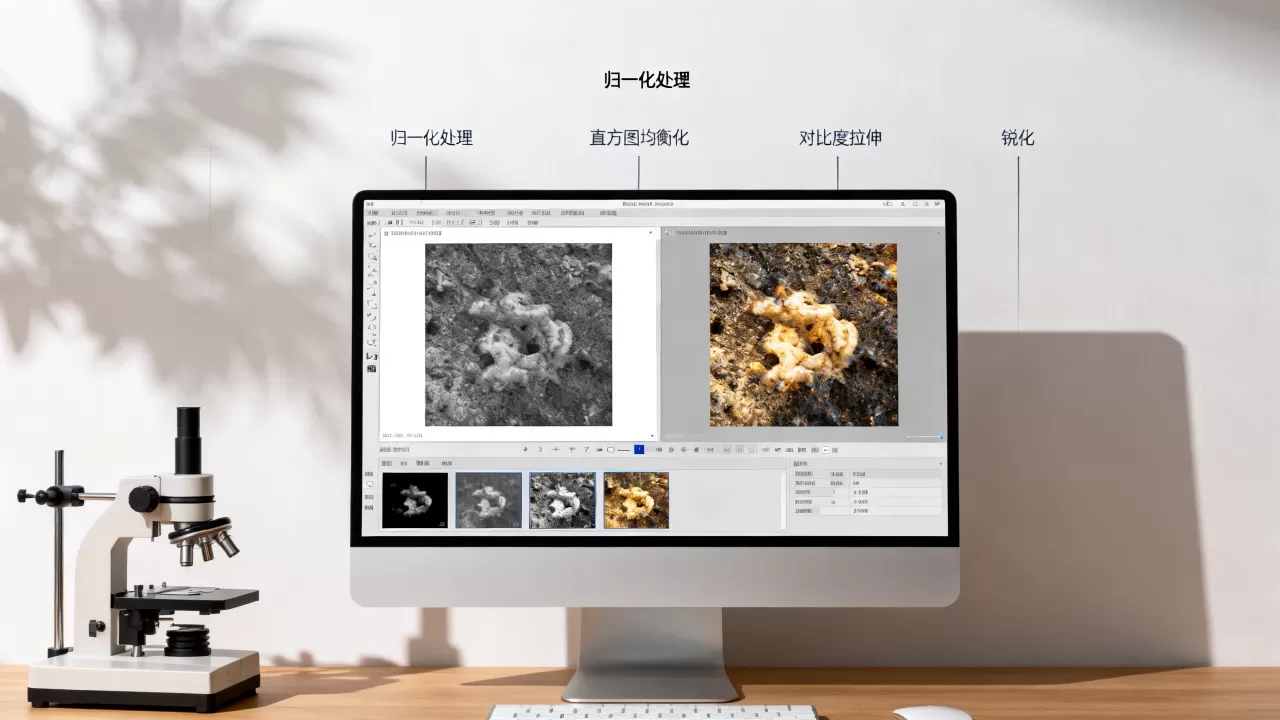
色彩和光照的变化是图像增强中的重要环节,通过调整亮度、对比度、饱和度和色相,可以模拟不同天气和光照条件下的图像,在阴天或夜晚拍摄的图像通常亮度较低、对比度较差,通过增强这些属性,模型可以更好地适应低光照环境。
噪声添加与模糊
添加高斯噪声或进行高斯模糊,可以模拟传感器噪声或运动模糊,这种增强策略有助于提高模型对噪声的鲁棒性,防止模型过度拟合训练数据中的清晰细节。
预处理与增强的协同工作
在实际的深度学习项目中,归一化和图像增强通常协同工作,共同构建高效的数据管道,理解它们的先后顺序和相互作用,对于优化模型性能至关重要。
标准数据处理流程
一个典型的图像数据处理流程通常遵循以下顺序:
- 读取图像:从磁盘或数据库加载原始图像数据。
- 图像增强:应用几何变换、色彩调整等增强操作,增加数据多样性。
- 归一化处理:将增强后的图像像素值映射到标准化区间,确保数值稳定性。
- 模型训练:将预处理后的数据输入神经网络进行训练。
为什么先增强后归一化?
这一顺序的选择基于数学逻辑,图像增强操作(如旋转、缩放)通常是在像素空间进行的,如果先进行归一化,可能会引入不必要的浮点误差,或者使得某些增强操作(如基于像素值的阈值分割)变得复杂,归一化后的数据范围固定,便于统一应用增强参数。
行业共识认为,数据管道的顺序对模型性能有细微但重要的影响,先增强后归一化,可以确保增强操作在原始像素空间中进行,保持语义的完整性;随后通过归一化,将处理后的数据转换为模型易于处理的格式。
常见误区与最佳实践
尽管归一化和图像增强的区别看似明确,但在实际应用中,仍存在一些常见的误区。
归一化能提升图像质量
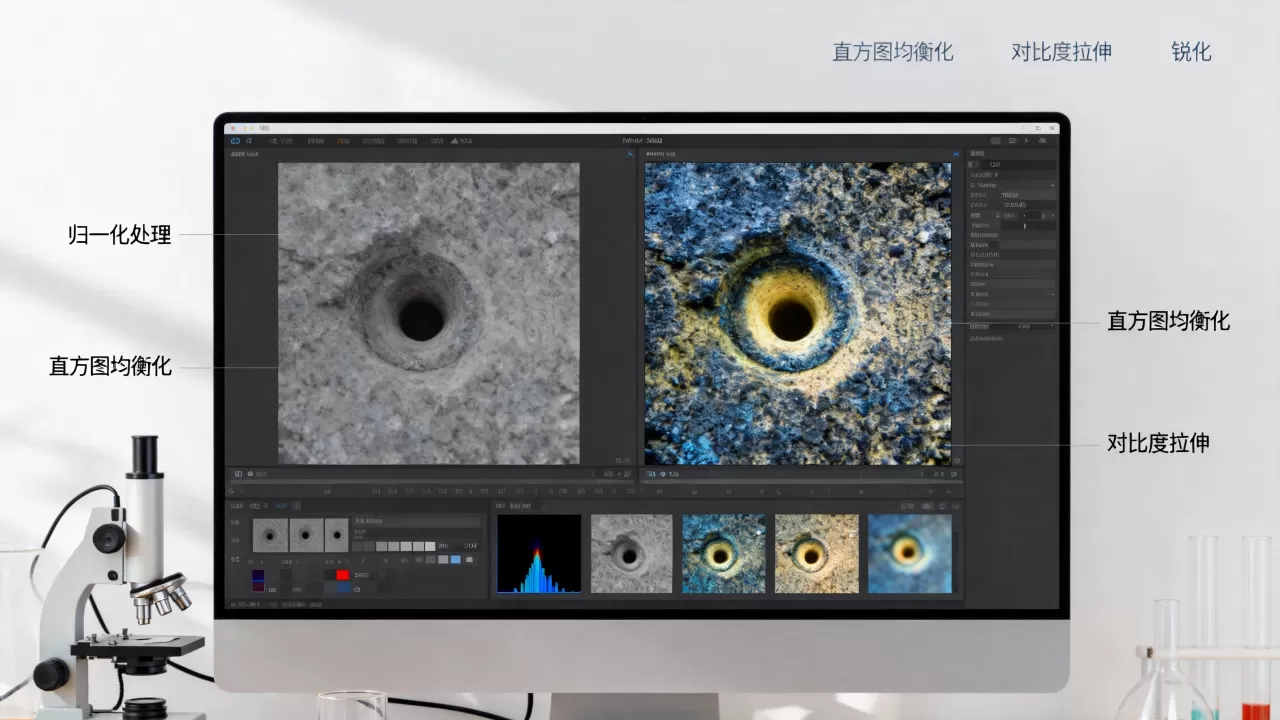
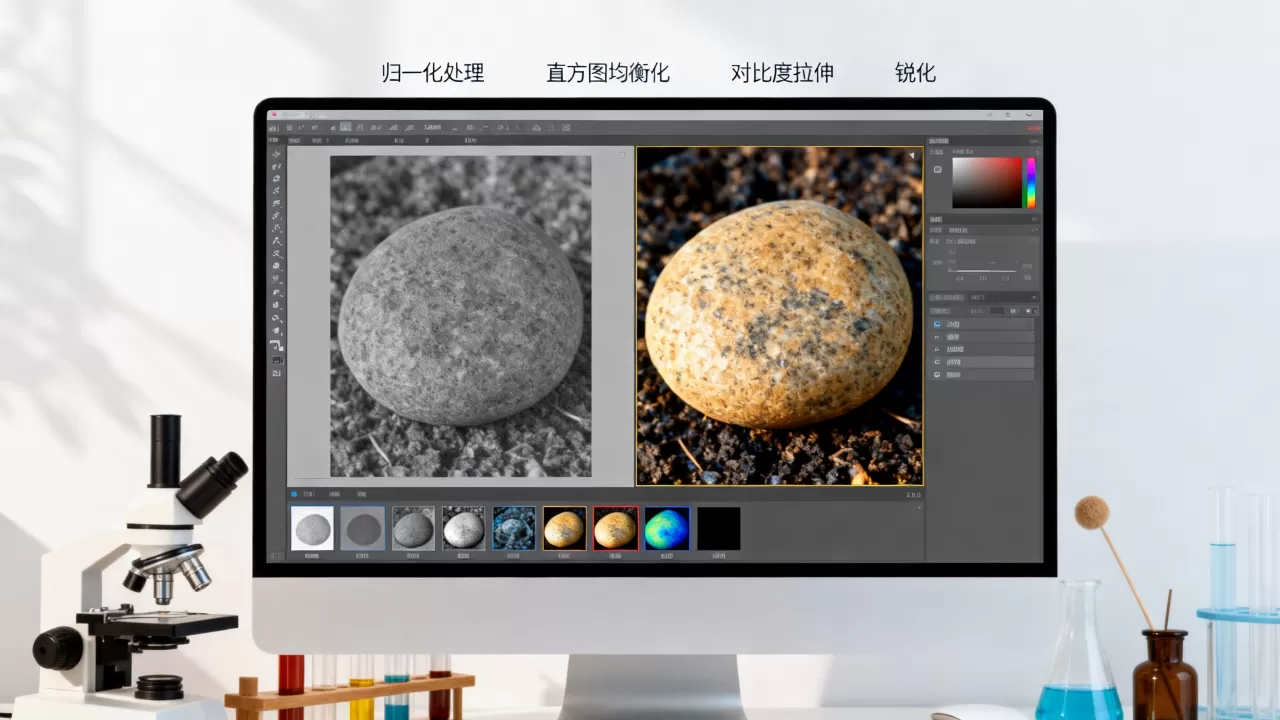
许多初学者误以为归一化能提升图像的清晰度或对比度,归一化只是线性变换,不会改变图像的相对亮度或对比度,如果需要提升图像质量,应使用直方图均衡化或自适应对比度增强等专门的图像增强技术。
增强越多越好
虽然图像增强能提升泛化能力,但过度的增强可能导致语义失真,过度的旋转可能导致物体方向错误,过度的色彩调整可能改变物体的固有颜色,最佳实践是根据具体任务和数据分布,选择合适的增强策略和强度。
最佳实践建议
- 根据任务选择增强策略:对于目标检测任务,几何变换尤为重要;对于分类任务,色彩和光照调整可能更有效。
- 监控训练过程:通过观察损失曲线和验证集准确率,判断是否需要调整增强强度或归一化参数。
- 保持数据一致性:确保训练集、验证集和测试集使用相同的预处理和增强策略,避免数据分布不一致导致的性能偏差。
Q&A:关于归一化与图像增强的常见疑问
归一化处理属不属于图像增强的一种?
不属于,归一化是数据预处理步骤,旨在统一数据分布以加速模型收敛;图像增强是通过变换增加数据多样性以提升模型泛化能力,两者目的不同,不可混淆。
在图像预处理中,归一化和数据增强应该按什么顺序执行?
通常建议先执行图像增强,再执行归一化,这样可以确保增强操作在原始像素空间中进行,保持语义完整性,随后通过归一化将数据转换为模型易于处理的标准化格式。
如果不进行归一化处理,直接使用原始像素值训练模型会有什么后果?
可能导致梯度爆炸或消失,模型收敛速度极慢甚至无法收敛,不同特征间的尺度差异可能导致模型偏向于数值较大的特征,影响最终性能。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/283934.html