当您看到“服务器服务器出问题了”的提示或遭遇网站、应用突然无法访问时,意味着承载核心业务的关键基础设施出现了故障,这绝非小事,它直接冲击业务的连续性、用户体验和品牌声誉。解决服务器故障的核心在于快速、精准地定位问题根源并执行有效恢复措施,同时建立预防机制降低未来风险。 立即行动是关键。
服务器故障的快速排查与诊断 (应急响应)
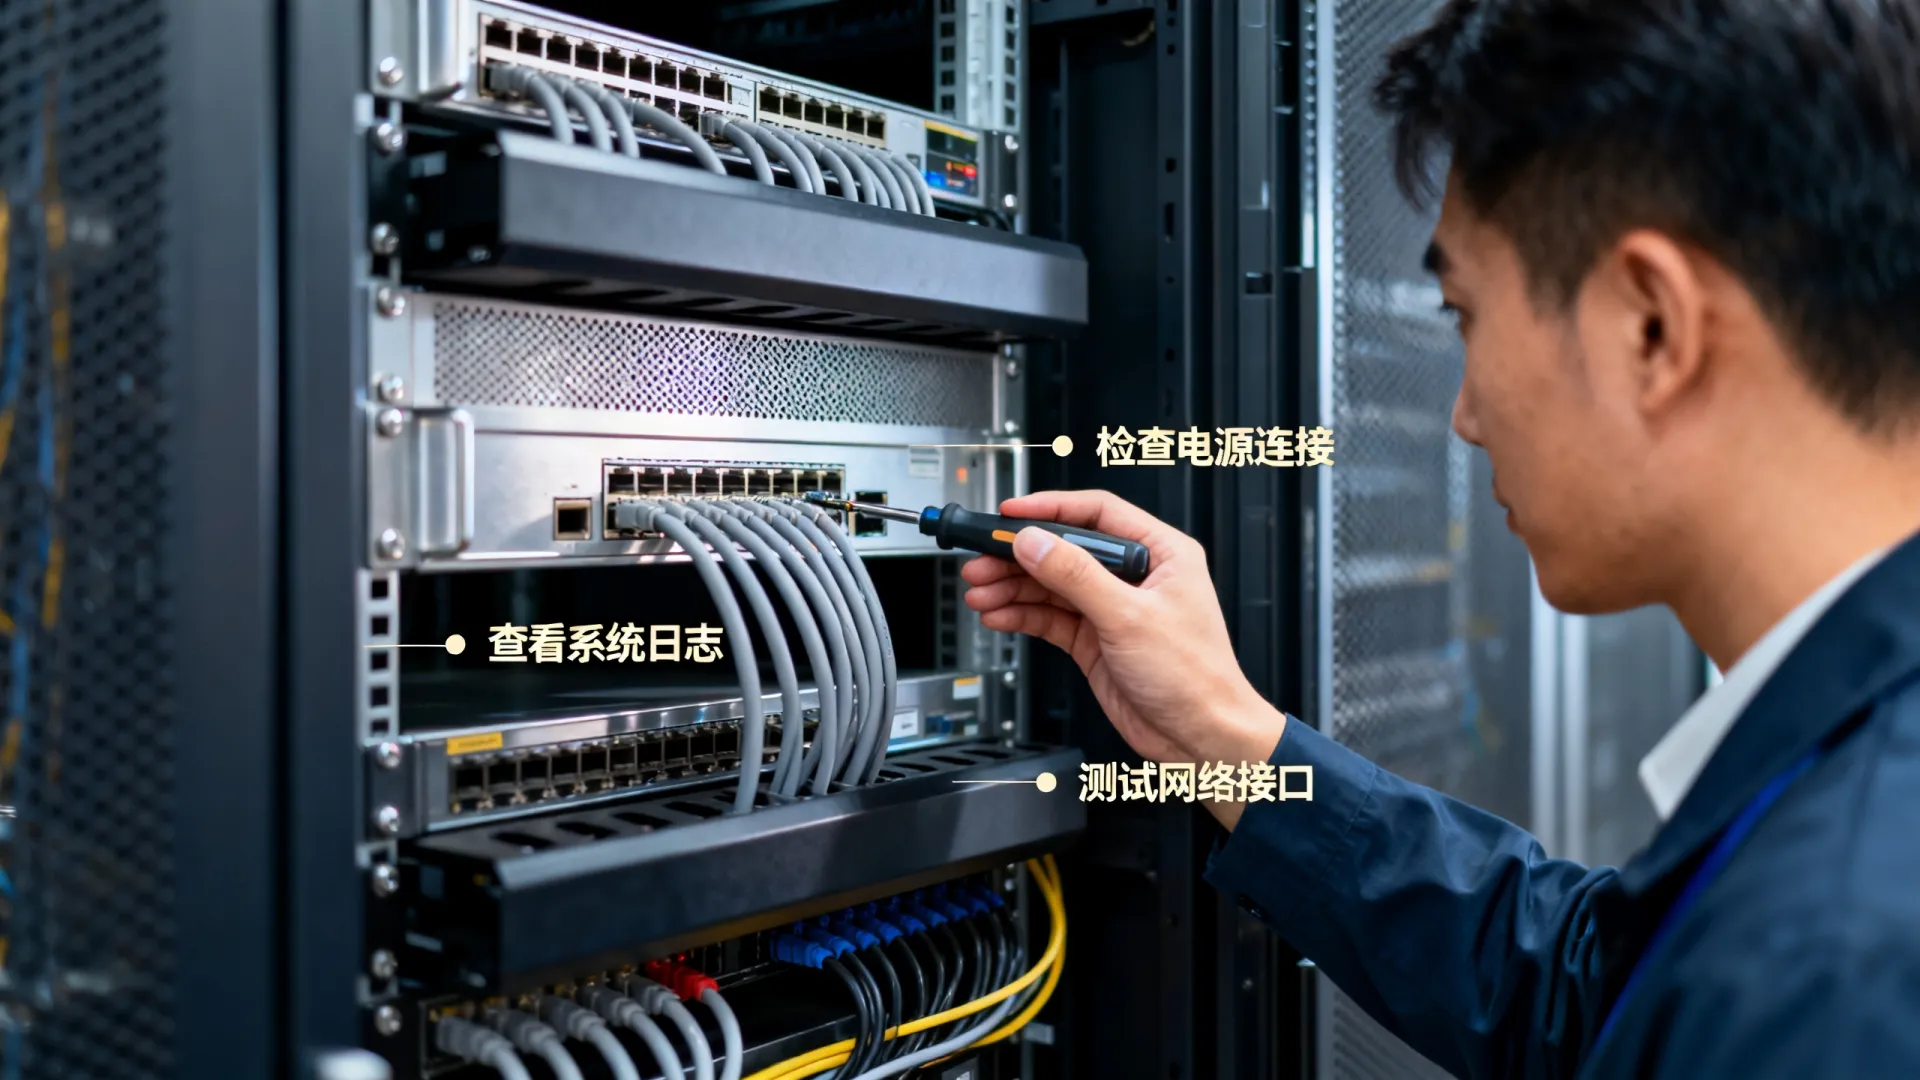
面对突发故障,保持冷静,按优先级进行系统化排查:
-
基础连接与状态检查:
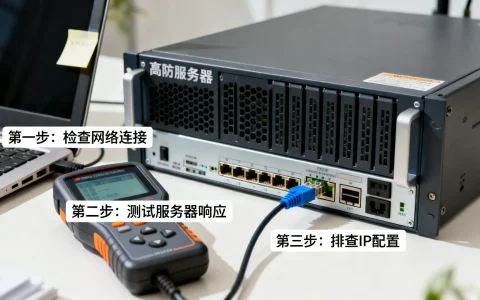
- 网络可达性: 使用
ping、traceroute(Windows:tracert) 命令测试服务器IP是否可达,判断是网络中断还是服务器本身问题,检查物理网线、交换机端口状态、防火墙规则。 - 远程访问能力: 尝试通过SSH (Linux/Unix) 或 RDP (Windows) 连接服务器,失败可能表明操作系统崩溃、关键服务(如sshd, RDP服务)未运行或网络限制。
- 硬件状态指示灯: 如果条件允许(物理机或IDC),查看服务器面板的电源、硬盘、网络等指示灯状态(如红灯常亮/闪烁通常表示故障)。
- 网络可达性: 使用
-
关键资源监控分析:
- CPU利用率: 使用
top(Linux)、htop或任务管理器 (Windows) 查看CPU是否持续100%,识别消耗资源高的进程。 - 内存使用: 检查物理内存和Swap空间使用率 (
free -m/vmstatin Linux; 任务管理器 in Windows),内存耗尽会导致系统卡顿、崩溃或进程被OOM Killer终止。 - 磁盘空间与I/O: 使用
df -h检查磁盘分区是否已满(特别是 ,/var,/tmp),使用iostat或iotop(Linux) / 资源监视器 (Windows) 检查磁盘I/O是否异常高,是否存在瓶颈或硬件故障。 - 系统负载: Linux下
uptime或w命令显示的负载平均值(1m, 5m, 15m)远高于CPU核心数通常表示系统过载。
- CPU利用率: 使用
-
服务与进程检查:
- 关键服务状态: 使用
systemctl status <service_name>(Systemd) 或service <service_name> status(SysVinit) 检查Web服务器(Nginx, Apache)、数据库(MySQL, PostgreSQL)、应用服务等核心进程是否运行 (active (running)),查看服务日志 (journalctl -u <service_name>或/var/log/<service>下的日志文件)。 - 端口监听: 使用
netstat -tulnp或ss -tulnp(Linux) /netstat -ano(Windows) 检查关键服务(如80, 443, 3306, 5432)是否在预期端口监听。
- 关键服务状态: 使用
-
日志审查 (诊断的金钥匙):
- 系统日志: 重点检查
/var/log/messages,/var/log/syslog(Linux) 或 事件查看器 (Windows – 系统、应用日志),寻找关键错误(ERROR,CRITICAL,Failed,kernel panic, OOM)、警告(WARNING)或异常事件(如硬件错误、文件系统错误、服务崩溃记录)。 - 应用日志: 检查Web服务器(
/var/log/nginx/error.log,/var/log/apache2/error.log)、数据库错误日志、应用自身的日志文件,这些日志通常包含最直接的错误信息和堆栈跟踪。
- 系统日志: 重点检查
服务器故障的常见根源剖析
排查后,问题通常指向以下几大类:
-
硬件故障:
- 硬盘故障: 磁盘坏道、RAID阵列降级或失效、SSD寿命耗尽,表现:I/O错误、文件系统损坏 (
fsck报错)、系统卡顿、数据丢失,SMART工具 (smartctl) 可辅助诊断。 - 内存故障: 内存条损坏导致数据错误,表现:系统崩溃、进程意外终止、数据损坏、内核
panic常提及内存相关错误,使用memtest86+进行深度检测。 - 电源问题: 电源模块故障、供电不稳,表现:服务器意外重启、宕机。
- CPU/主板/风扇故障: 相对少见,但会导致系统不稳定或无法启动,主板日志 (IPMI/iLO/iDRAC) 和温度监控是关键。
- 硬盘故障: 磁盘坏道、RAID阵列降级或失效、SSD寿命耗尽,表现:I/O错误、文件系统损坏 (
-
软件与系统问题:
- 资源耗尽: CPU、内存、磁盘空间、磁盘I/O、进程/文件描述符数达到上限,通常是应用设计缺陷、流量突增(如遭攻击)、配置不当(如缓存设置不合理)、日志未轮转导致。
- 系统/内核崩溃 (Panic/Oops): 内核级错误、关键驱动程序故障、硬件不兼容。
/var/log/kern.log或dmesg输出是线索。 - 文件系统损坏: 非正常关机、硬件故障可能导致,需要
fsck修复(有数据丢失风险)。 - 配置错误: 错误的系统参数 (
sysctl.conf)、服务配置文件 (Nginx/Apache conf, MySQLmy.cnf)、防火墙规则更新错误、错误的软件包升级或依赖冲突。 - 内核/系统更新问题: 更新后出现兼容性问题或引入了新Bug。
-
应用层问题:
- 程序Bug或内存泄漏: 应用代码缺陷导致崩溃或持续消耗资源直到耗尽。
- 数据库问题: 慢查询堆积、死锁、连接池耗尽、主从同步失败、数据库崩溃。
- 依赖服务故障: 应用依赖的外部API、缓存服务(Redis/Memcached)、消息队列(RabbitMQ/Kafka)等下游服务不可用,导致应用功能异常或连锁故障。
-
外部因素:
- 网络攻击: DDoS攻击耗尽带宽或服务器资源;暴力破解导致SSH等服务异常;恶意软件/挖矿程序消耗资源。
- 机房/基础设施问题: 电力中断、网络运营商故障、空调失效导致机房过热。
- 人为操作失误: 误删除关键文件、错误执行命令、不规范的变更操作。
专业的解决方案与最佳实践
解决当前问题并防止复发需要系统性的方法:
-
应急恢复 (止血):
- 资源扩容/清理: 临时增加CPU/内存/带宽(云服务器可弹性扩容);清理磁盘空间(删除无用文件、日志轮转、归档旧数据);重启耗尽资源的服务或进程(谨慎操作,可能丢失状态)。
- 服务重启: 按依赖顺序重启关键服务 (
systemctl restart),有时简单的重启能解决暂时性软件锁死问题。 - 故障转移: 如果配置了高可用(HA)集群,立即将流量切换到备用节点。
- 回滚变更: 若故障紧随配置变更或更新后发生,优先考虑回滚到已知稳定状态。
- 临时屏蔽攻击源: 利用防火墙(
iptables/firewalld, WAF)封禁恶意IP。
-
根本解决 (治本):
- 硬件更换/修复: 确认硬件故障后,及时更换坏盘(重建RAID)、故障内存、电源等,利用带外管理工具(IPMI/iDRAC/iLO)进行远程诊断和修复准备。
- 软件Bug修复与优化: 根据应用日志堆栈修复代码Bug;优化存在内存泄漏或性能瓶颈的代码;优化数据库慢查询、增加索引、调整配置参数 (
innodb_buffer_pool_size等)。 - 配置修正与加固: 修正错误的配置文件;优化系统内核参数 (
net.core.somaxconn,vm.swappiness等);加强安全配置(禁用密码SSH登录、最小化开放端口)。 - 依赖治理: 确保下游服务高可用;为应用添加熔断、降级、超时重试机制。
- 彻底清除恶意软件: 使用专业工具扫描 (
rkhunter,chkrootkit,ClamAV),分析异常进程和网络连接,必要时重装系统。
-
预防与韧性建设 (长效机制):
- 全面的监控告警体系:
- 监控指标:CPU、内存、磁盘(空间&IO)、网络流量、系统负载、关键服务状态、端口健康、业务核心指标(响应时间、错误率、吞吐量)。
- 工具:Prometheus + Grafana, Zabbix, Nagios, Datadog, 云厂商自带监控。
- 告警:设置合理阈值(如CPU>90%持续5分钟,磁盘>85%,服务Down),确保通知渠道(短信、邮件、钉钉、企业微信)有效,告警信息清晰可操作。
- 日志集中管理与分析:
使用ELK Stack (Elasticsearch, Logstash, Kibana) 或 Loki + Grafana 集中收集、索引、分析所有服务器和应用的日志,便于快速检索、关联分析、设置日志模式告警。
- 高可用 (HA) 与容灾设计:
- 基础设施层: 使用负载均衡器分发流量到多台应用服务器;数据库配置主从复制、读写分离,或采用集群方案(如MySQL Group Replication, Galera, Redis Cluster)。
- 架构层: 设计无状态应用,便于水平扩展;关键数据持久化并备份;考虑多可用区(AZ)或多地域部署以应对机房级故障。
- 容灾演练: 定期进行故障切换演练,验证预案有效性。
- 变更管理与自动化:
- 严格变更流程: 所有线上变更需评审、在低峰期进行、有回滚计划、并监控变更后状态。
- 基础设施即代码 (IaC): 使用Terraform、Ansible等工具自动化服务器和服务的部署、配置管理,确保环境一致性,快速重建。
- 自动化运维: 利用脚本或运维平台自动化日常任务(如日志清理、备份、健康检查)。
- 定期备份与恢复验证:
- 制定备份策略(全量+增量/差异),涵盖系统配置、应用代码、数据库、重要文件。
- 备份存储遵循3-2-1原则(至少3份副本,2种不同介质,1份异地)。
- 定期执行恢复演练,验证备份的可用性和恢复流程的有效性,没有验证的备份等于没有备份。
- 安全防护纵深:
- 及时修复系统和应用漏洞。
- 部署防火墙、WAF、入侵检测/防御系统 (IDS/IPS)。
- 定期进行安全审计和渗透测试。
- 最小权限原则管理服务器访问。
- 全面的监控告警体系:
服务器故障是运维工作的严峻挑战,但更是优化架构、提升韧性的契机,快速精准的响应源于扎实的日常监控和清晰的预案;而根治问题、避免复发,则依赖于对根因的深入分析、系统性修复以及持续投入在监控、高可用、自动化、备份和安全等基础能力的建设上,将每一次故障转化为系统健壮性提升的阶梯,是专业运维的核心价值。
您的服务器最近一次故障是什么原因引起的?在提升系统稳定性方面,您认为最有效的措施是什么?欢迎在评论区分享您的实战经验和见解!
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/27651.html