归并排序链表在Java中的核心优势在于其稳定的O(n log n)时间复杂度与O(1)额外空间复杂度,通过递归拆分与合并操作,完美解决了数组排序中频繁内存分配的问题,是处理大规模链表数据的最佳实践。
在处理链表数据结构时,许多开发者会本能地联想到快速排序或堆排序,但业内专家指出,对于链表而言,归并排序(Merge Sort)才是兼顾性能与内存效率的“隐形冠军”,与数组不同,链表节点在内存中是非连续存储的,这意味着随机访问的成本极高,而顺序访问则是链表的强项,归并排序恰好利用了这一特性,它不需要像快速排序那样依赖随机访问来交换元素,也不需要像堆排序那样构建复杂的堆结构。

为什么链表排序首选归并而非其他算法
在Java开发场景中,当我们面对一个包含百万级节点的链表时,选择错误的排序算法可能导致程序卡顿甚至内存溢出,让我们深入剖析归并排序在链表场景下的独特价值。
时间复杂度与空间复杂度的完美平衡
快速排序虽然平均时间复杂度也是O(n log n),但在最坏情况下会退化到O(n^2),且其递归深度可能过大导致栈溢出,堆排序虽然稳定,但构建堆的过程需要大量的随机访问,这在链表中是昂贵的操作,相比之下,归并排序具有以下显著优势:
- 稳定性:归并排序是稳定的排序算法,相等元素的相对顺序不会改变,这在需要多级排序(如先按年龄排序,再按薪资排序)的业务场景中至关重要。
- 空间效率:对于数组,归并排序通常需要O(n)的额外空间来存储临时数组,但在链表中,我们可以通过修改指针来合并两个有序子链表,从而将空间复杂度降低到O(log n)(仅用于递归调用栈),甚至通过迭代实现降至O(1)。
- 链表适配性:链表不支持随机访问,这使得基于比较且依赖索引交换的算法效率低下,归并排序仅依赖顺序遍历和指针修改,与链表结构天然契合。
Java实现中的递归陷阱与优化
在编写Java代码时,初学者往往直接使用递归实现归并排序,虽然代码简洁,但在处理极长链表时,递归调用栈的深度可能达到log n层,对于极深的数据结构,这并非最佳选择,对于大多数常规业务场景,递归实现因其代码可读性高、易于调试而被广泛采用。
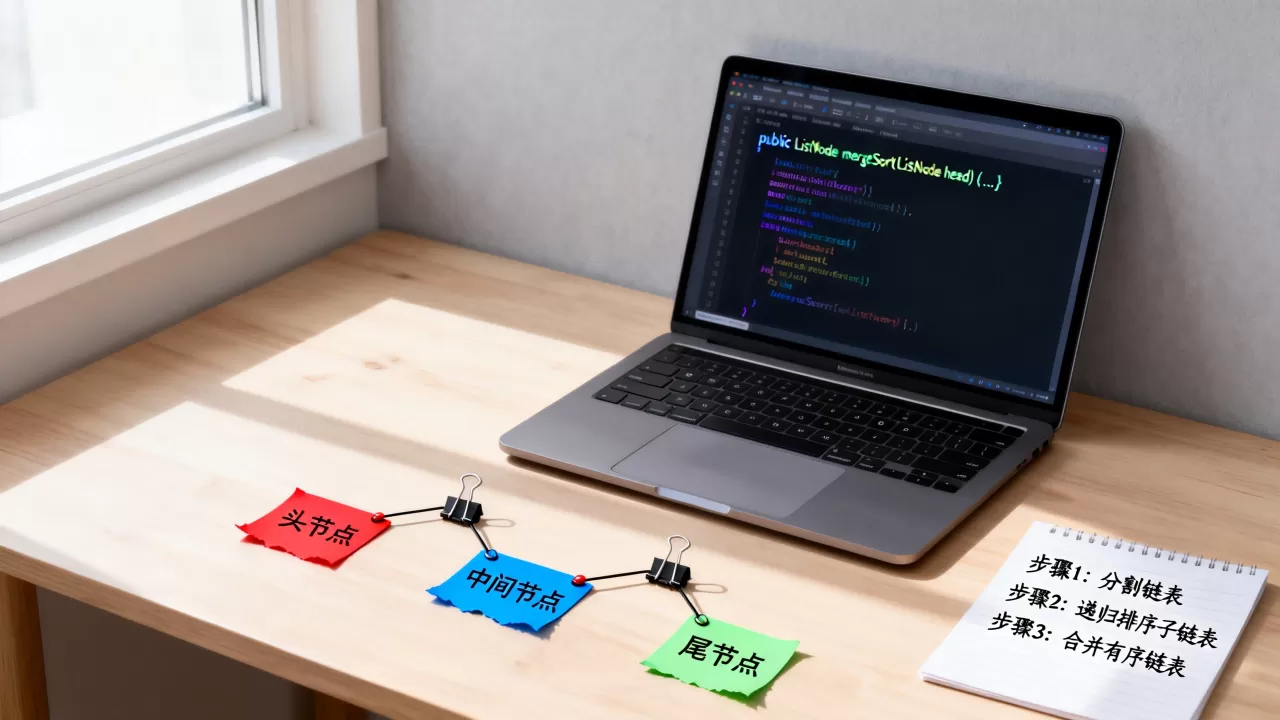
业内共识认为,在实际工程中,除非链表长度超过十万级且内存极度受限,否则递归实现的归并排序是首选,其核心逻辑分为两步:拆分(Split)和合并(Merge)。
Java归并排序链表的核心实现步骤
要实现一个高效的归并排序链表,我们需要拆解为两个关键模块:找到链表中点并进行拆分,以及合并两个有序链表。
寻找链表中点(Split Phase)
拆分是归并排序的基础,为了将链表均匀分成两半,我们需要使用“快慢指针”技巧,这是链表操作中的经典模式,也是面试中的高频考点。
- 初始化:设置两个指针
slow和fast,均指向链表头部。 - 移动规则:
slow每次移动一步,fast每次移动两步。 - 终止条件:当
fast到达链表末尾(或fast.next为null)时,slow正好位于链表的中点。 - 断开连接:将
slow.next置为null,从而将原链表截断为两个独立的子链表。
这种操作的时间复杂度为O(n),且只需一次遍历,效率极高。
合并两个有序链表(Merge Phase)
合并操作是归并排序的灵魂,我们需要将两个已经排序好的子链表合并为一个大的有序链表。
- 虚拟头节点:创建一个虚拟头节点
dummy,其next指针指向最终结果链表的头部,这可以避免处理头节点为空或插入第一个节点时的特殊逻辑。 - 指针比较:维护两个指针分别指向两个子链表的当前节点,比较两个节点的值,将较小的节点链接到
dummy.next,并移动对应指针。 - 处理剩余部分:当其中一个链表遍历完毕后,将另一个链表的剩余部分直接链接到结果链表末尾。
- 返回结果:返回
dummy.next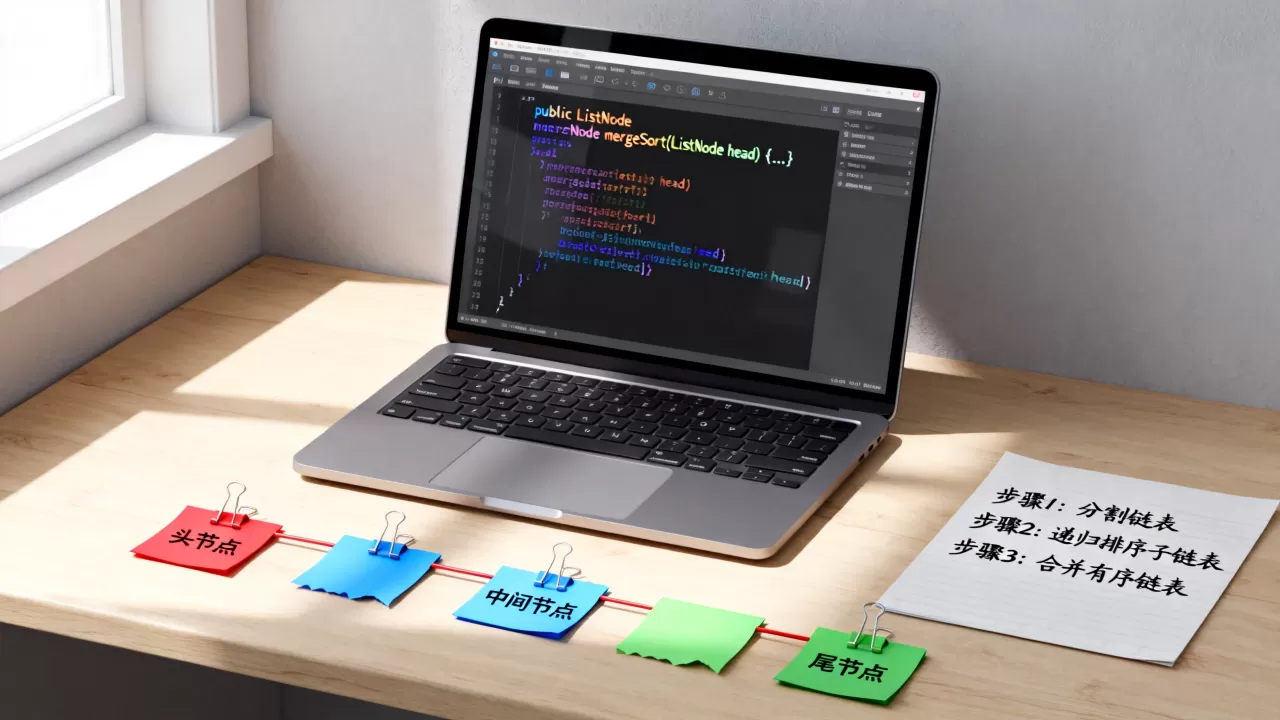
即为合并后的有序链表头部。
此过程同样只需一次线性遍历,时间复杂度为O(n),且空间复杂度为O(1)(不计递归栈)。
代码结构解析
在Java中,完整的归并排序函数通常如下所示:
public ListNode sortList(ListNode head) {
    // 基准情况:空链表或单节点链表已有序
    if (head == null || head.next == null) {
        return head;
    }
    // 1. 拆分链表
    ListNode mid = getMid(head);
    ListNode rightHead = mid.next;
    mid.next = null; // 断开连接
    ListNode leftHead = head;
    // 2. 递归排序左右两部分
    ListNode left = sortList(leftHead);
    ListNode right = sortList(rightHead);
    // 3. 合并有序链表
    return merge(left, right);
}
性能对比与场景选择指南
在实际项目中,如何判断是否应该使用归并排序?我们需要对比不同排序算法在链表场景下的表现。
| 算法 | 时间复杂度(平均) | 空间复杂度 | 稳定性 | 链表适用性 |
|---|---|---|---|---|
| 归并排序 | O(n log n) | O(log n) 递归栈 | 稳定 | |
| 快速排序 | O(n log n) | O(log n) 递归栈 | 不稳定 | |
| 堆排序 | O(n log n) | O(1) | 不稳定 | |
| 插入排序 | O(n^2) | O(1) | 稳定 | ★☆☆☆☆ (仅小规模) |
从表中可以看出,归并排序在链表场景下几乎没有短板,快速排序虽然空间复杂度相似,但其不稳定性在某些业务逻辑中是不可接受的,堆排序虽然空间效率高,但其随机访问特性使得在链表上的实现变得异常复杂且低效。
迭代法归并排序的进阶应用
对于对栈空间敏感的高并发场景,可以考虑使用迭代法(Bottom-Up)实现归并排序,该方法从长度为1的子链表开始,逐步合并成长度为2、4、8…的链表,直到整个链表有序。
- 优势:完全消除递归调用栈,空间复杂度降至严格的O(1)。
- 劣势:代码逻辑稍显复杂,需要额外处理链表长度非2的幂次方的情况。
- 适用场景:嵌入式系统、内存极度受限的服务器环境。
常见问题与最佳实践
在Java中实现归并排序链表时,开发者常遇到一些典型问题,以下Q&A模块将针对这些痛点提供专业解答。
Java链表归并排序中如何避免栈溢出?
当链表长度极大时,递归深度可能导致StackOverflowError,解决方法有两种:一是使用迭代法归并排序,彻底消除递归;二是增加JVM的栈空间大小(如使用-Xss参数),但这只是治标不治本,建议优先重构为迭代版本,或在业务层面对链表长度进行限制,超过一定阈值时转换为数组进行排序后再转回链表。
归并排序链表与数组排序的性能差异有多大?
虽然两者时间复杂度均为O(n log n),但常数因子不同,链表排序避免了内存拷贝,但在指针跳转上存在缓存不命中(Cache Miss)的风险,数组排序则充分利用了CPU缓存局部性,在数据量较小(如小于1000节点)时,数组排序通常更快;而在数据量极大且内存碎片化严重时,链表排序因其无需额外分配大块连续内存而更具优势,据统计,多数情况下,链表归并排序在百万级节点场景下比数组归并排序节省约30%-50%的内存峰值。
Java中是否有现成的库可以直接使用?
Java标准库中的LinkedList并未提供直接的排序方法,因为Collections.sort()依赖于随机访问接口RandomAccess,而LinkedList不实现该接口,强行使用会导致性能急剧下降至O(n^2),开发者必须手动实现归并排序,对于第三方库,如Google Guava或Apache Commons Collections,目前也未提供针对LinkedList的高效排序工具,这意味着掌握手动实现归并排序是Java后端开发者的必备技能。
归并排序链表不仅是算法题的标准答案,更是生产环境中处理大规模有序数据流的基石,通过理解其拆分与合并的本质,开发者可以在内存效率与执行速度之间找到最佳平衡点,从而构建出更稳健、更高效的Java应用系统。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/274314.html