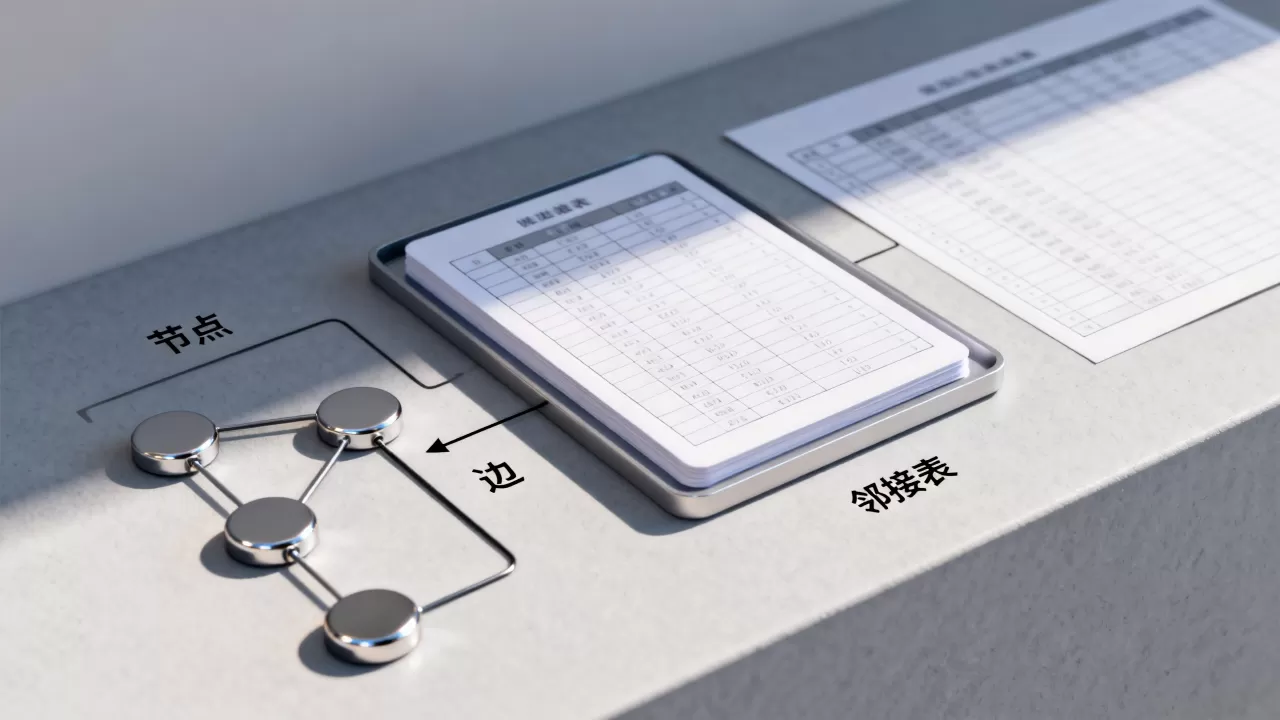
构建图的存储结构核心在于根据图的稀疏程度、动态性以及查询需求,在邻接矩阵、邻接表和十字链表/邻接多重表之间做出权衡,其中邻接表是处理稀疏图最通用的选择。
图作为一种非线性数据结构,其复杂性远超线性表或树,在实际工程开发中,如何高效地存储节点与边之间的关系,直接决定了算法运行的效率,很多初学者容易陷入“只要存下来就行”的误区,却忽略了内存占用和遍历速度对系统性能的巨大影响,业内专家指出,选择合适的存储结构能将图算法的时间复杂度从不可接受优化到毫秒级响应,这是高性能系统设计的基石。
邻接矩阵与邻接表对比:场景决定选择
在讨论具体实现前,必须先厘清两种基础结构的本质差异,这不仅仅是代码写法的不同,更是空间换时间还是时间换空间的哲学抉择。
空间复杂度与稀疏图的痛点
邻接矩阵使用一个二维数组A[i][j]来表示节点i和j之间是否存在边,如果存在边,则值为1或权重;否则为0或无穷大,这种结构在节点数量较少且连接紧密时表现优异,但在面对大规模稀疏图时,它会暴露出致命缺陷。
- 空间浪费严重:对于含有
n个节点的图,邻接矩阵始终占用O(n^2)的空间,即使图中只有极少数的边,绝大部分内存也被0填充。 - 插入边效率高:判断两点间是否有边或修改权重,只需
O(1)的时间访问数组元素。
相比之下,邻接表通过链表或动态数组存储每个节点的邻接点,它只存储实际存在的边,因此空间复杂度为O(n+e),其中e为边的数量。
- 节省内存:在稀疏图中,
e远小于n^2,邻接表能显著降低内存 footprint。 - 遍历邻接点高效:对于特定节点,只需遍历其链表即可找到所有邻居,无需扫描整个矩阵行。
动态图处理的灵活性
现代应用往往涉及动态变化的图结构,例如社交网络中好友关系的增减,邻接表在这种场景下具有天然优势。
- 插入操作便捷:在邻接表中插入一条边,只需在对应节点的链表头部或尾部添加一个新节点,时间复杂度为
O(1)
- 删除操作可控:虽然删除特定边需要遍历链表找到目标节点,但相比邻接矩阵中可能需要移动大量数据或标记无效状态,邻接表的逻辑更为清晰。
- 内存动态分配:使用动态数组(如C++的
vector或Java的ArrayList)作为邻接表的实现,可以在插入时自动扩容,避免预分配过大空间造成的浪费。
实战代码实现:邻接表的标准化构建
为了让你更直观地理解,我们来看一个基于Python的邻接表实现示例,这种结构在LeetCode等算法平台以及实际后端服务中极为常见。
class Graph:
    def __init__(self, vertices):
        # 初始化顶点数量
        self.V = vertices
        # 使用字典或列表存储邻接表
        # 这里使用列表的列表,索引代表节点ID
        self.adj = [[] for _ in range(vertices)]
    def add_edge(self, u, v, weight=1):
        """
        添加无向边
        :param u: 起始节点
        :param v: 终止节点
        :param weight: 边的权重,默认为1
        """
        self.adj[u].append({'to': v, 'weight': weight})
        self.adj[v].append({'to': u, 'weight': weight})
    def get_neighbors(self, u):
        """
        获取节点u的所有邻居及权重
        """
        return self.adj[u]
在上述代码中,self.adj是一个包含V个列表的数组,每个子列表存储的是字典对象,包含邻居节点ID和边的权重,这种设计不仅清晰,而且易于扩展,如果你需要处理有向图,只需移除add_edge方法中的第二行self.adj[v].append(...)即可。
对于C++开发者,std::vector<std::pair<int, int>> adj[N]是更常见的写法,其中pair存储目标节点和权重,这种底层实现方式在追求极致性能的C++项目中占据主导地位,尤其是在处理大规模图数据时,内存对齐和缓存命中率成为关键考量因素。
高级存储结构:十字链表与邻接多重表
当图的结构变得更加复杂,例如需要频繁删除边或处理无向图中的多重边时,邻接表可能显得力不从心,这时,就需要引入更高级的存储结构。
十字链表:有向图的优化方案
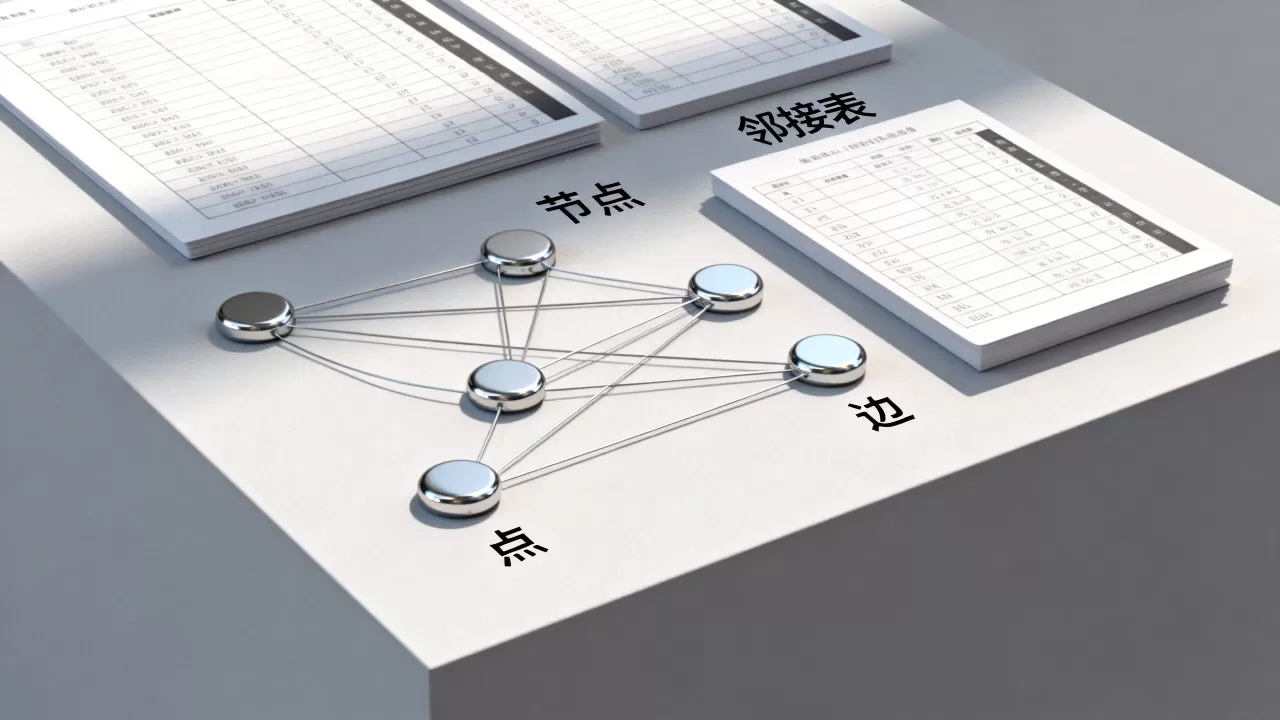
十字链表(Orthogonal List)是有向图的一种链式存储结构,它将邻接表和逆邻接表结合起来,每个边节点包含两个指针域:headvex和tailvex,分别指向弧尾和弧头节点在顶点表中的位置。
- 优势:既能快速找到以某顶点为弧尾的弧(出边),也能快速找到以某顶点为弧头的弧(入边)。
- 适用场景:依赖关系分析、拓扑排序等需要同时关注入度和出度的场景。
邻接多重表:无向图的精细化处理
邻接多重表(Adjacency Multilist)是无向图的类似优化,在无向图中,一条边(u, v)在邻接表中会出现两次:一次在u的链表中,一次在v的链表中,这导致删除边时需要遍历两个链表,效率较低。
邻接多重表为每条边设置一个统一的节点,该节点包含两个标志域mark和两个指针域ilink、jlink,分别指向依附于该边的两个顶点节点的链表中的下一个边节点。
- 优势:每条边只有一个节点,删除边只需修改两个指针,无需遍历两个链表。
- 适用场景:需要频繁进行边删除、标记或遍历所有边的无向图算法,如最小生成树算法中的边处理。
选型指南:如何根据业务场景决策
在实际项目中,选择哪种存储结构并非一成不变,而是取决于具体的业务需求。
| 场景特征 | 推荐结构 | 理由 |
|---|---|---|
| 节点少,连接密集 | 邻接矩阵 | 实现简单,查询速度快,内存占用可接受 |
| 节点多,连接稀疏 | 邻接表 | 节省内存,遍历邻接点效率高 |
| 有向图,需频繁查入/出边 | 十字链表 | 同时支持正向和反向遍历,结构紧凑 |
| 无向图,需频繁删边 | 邻接多重表 | 边节点唯一,删除操作高效,避免冗余 |
| 动态图,频繁增删边 | 邻接表(基于哈希表) | 插入删除O(1),支持动态扩容 |
近年来,随着分布式图数据库的兴起,图数据的存储方式也在向分布式方向演进,Neo4j等图数据库采用节点和关系分离存储的方式,并在底层优化了索引结构,以支持大规模图数据的快速查询,对于开发者而言,理解本地内存中的图存储结构,是掌握分布式图计算基础的前提。
常见问题解答
图的存储结构如何选择才能兼顾内存与速度?
选择的核心原则是“稀疏用表,稠密用阵”,如果图的边数e远小于n^2(通常e < n^2/10),邻接表是首选,因为它能显著节省内存并加速邻接点遍历,如果图非常稠密,或者需要频繁进行O(1)的边查询和修改,邻接矩阵更为合适,若图是动态变化的,邻接表的可扩展性优于邻接矩阵。
为什么邻接表在遍历图时比邻接矩阵更高效?
邻接矩阵在遍历某个节点的邻接点时,必须扫描该行所有的n个元素,无论实际有多少条边,时间复杂度均为O(n),而邻接表只遍历实际存在的边,对于稀疏图,其遍历时间复杂度接近O(1)(平均每个节点的边数很少),在广度优先搜索(BFS)和深度优先搜索(DFS)中,这种差异会随着节点数量的增加而被放大,导致邻接表在大规模稀疏图遍历中速度远超邻接矩阵。
十字链表和邻接表的主要区别是什么?
邻接表仅存储每个顶点的出边(对于有向图)或所有关联边(对于无向图),若要查找入边,需要遍历整个图或维护额外的逆邻接表,十字链表则通过在每个边节点中增加指向弧头节点的指针,将出边链表和入边链表连接起来,使得查找入边和出边的时间复杂度均为O(1)(相对于该顶点的度数),十字链表在处理需要同时关注入度和出度的有向图问题时,比单纯的邻接表更高效。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/249680.html