构建网络知识图谱的核心在于将非结构化数据转化为结构化实体关系,通过实体抽取、关系识别与属性融合三大步骤,实现从海量信息到可计算知识的跨越,从而显著提升搜索引擎的理解能力与推荐精准度。
在数字化浪潮席卷全球的今天,数据如同汪洋大海,而知识则是指引航向的灯塔,传统的搜索引擎依赖关键词匹配,往往只能找到“包含这些词”的页面,却无法理解“这些词背后的含义”,知识图谱(Knowledge Graph)的出现,彻底改变了这一局面,它不再把网页看作孤立的文本块,而是将其拆解为一个个具体的实体(如人物、地点、事件)以及它们之间错综复杂的关系(如“出生于”、“隶属于”、“擅长”),这种结构化的表达方式,让机器真正拥有了“理解”世界的能力。
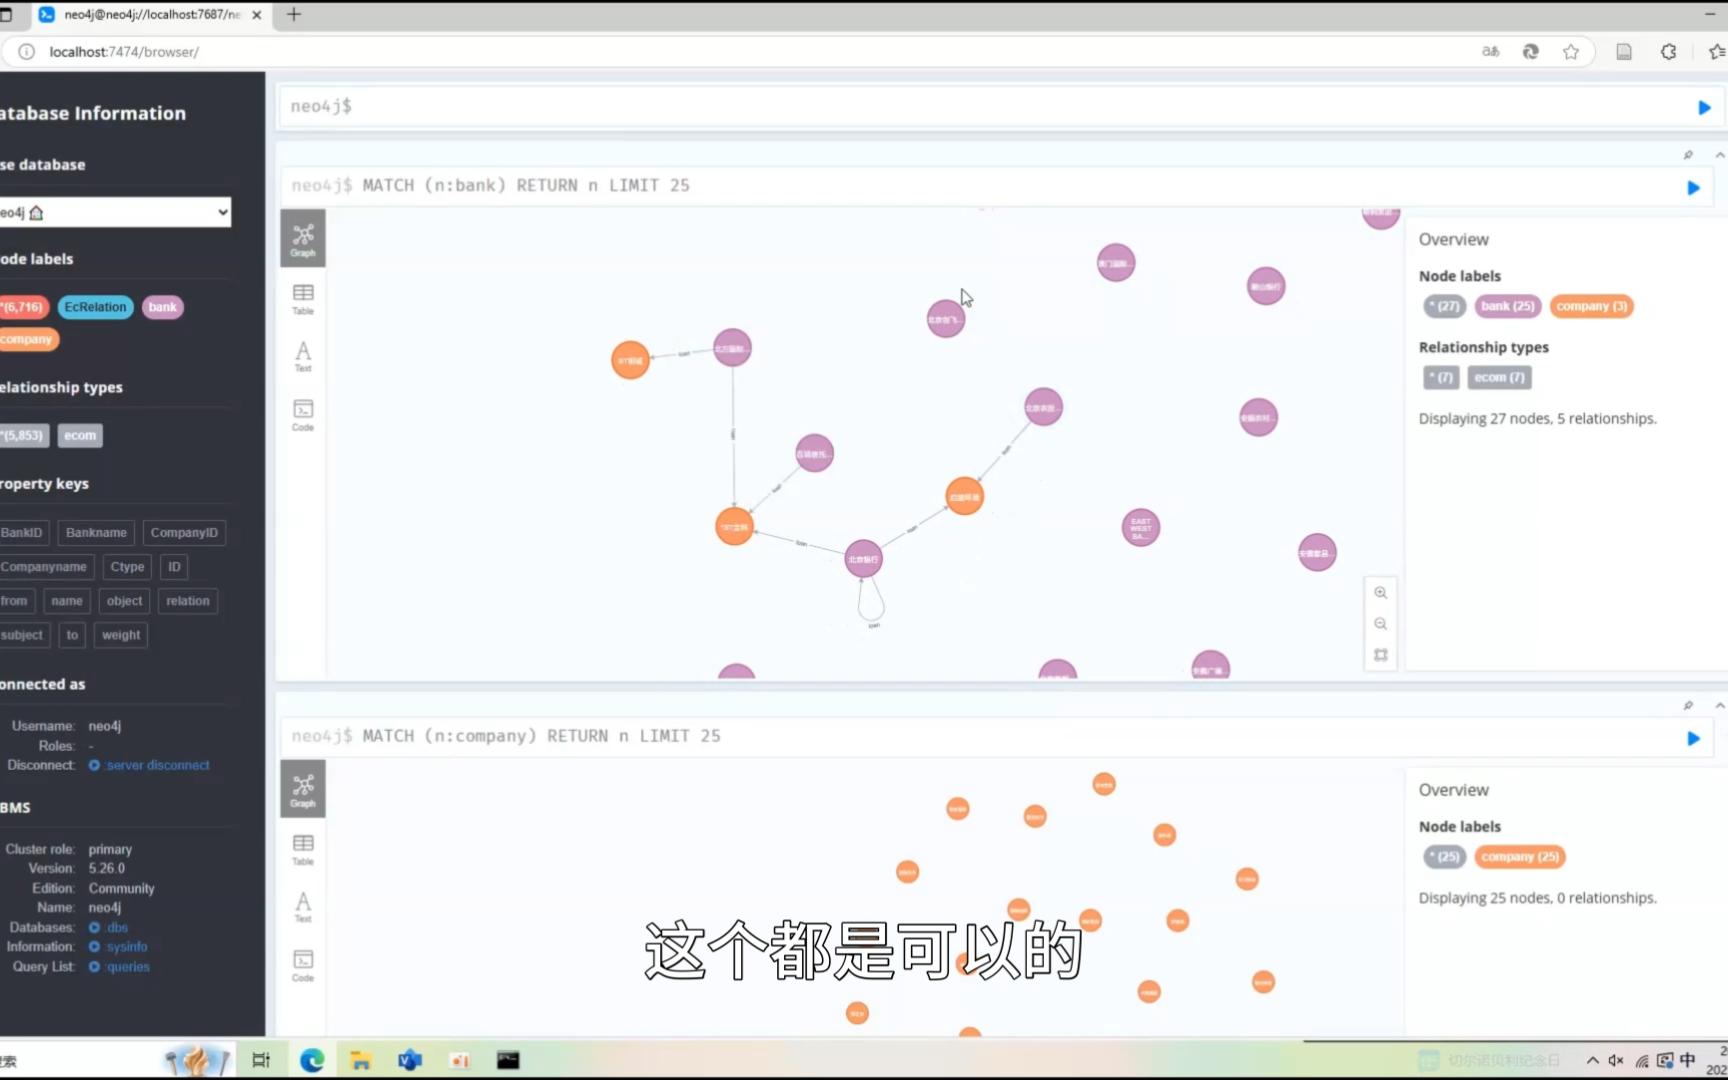
为什么企业需要构建网络知识图谱
对于许多正在探索数字化转型的企业而言,构建知识图谱并非为了赶时髦,而是为了解决实际业务中的痛点,业内专家指出,知识图谱在提升搜索质量、优化推荐系统以及辅助决策支持方面具有不可替代的作用。
提升搜索与推荐的精准度
传统的搜索系统在处理复杂查询时往往力不从心,当用户搜索“适合初学者的Python编程书籍”时,传统系统可能只匹配包含这些关键词的文章,结果混杂且杂乱,而基于知识图谱的搜索系统能够识别出“Python”是一门编程语言,“初学者”意味着需要低门槛、案例丰富的内容,进而从图谱中检索出与这些实体关联度高的书籍和教程。
这种语义搜索能力带来了显著的用户体验提升:
- 意图识别更准确:系统能理解同义词和上下文语境,避免歧义。
- 结果排序更智能:根据实体间的关联强度进行排序,而非仅仅依据关键词密度。
- 长尾需求被满足:即使查询词非常具体,图谱也能通过多跳关系找到相关答案。
打破数据孤岛,实现资产化
大多数企业的数据分散在不同的系统中:客户关系管理(CRM)系统、产品数据库、客服记录、社交媒体评论等,这些数据格式各异,彼此孤立,形成了所谓的“数据孤岛”,构建网络知识图谱的过程,本质上是一个数据治理与融合的过程。
通过实体对齐和关系抽取,企业可以将分散的数据源整合成一个统一的视图,将CRM中的客户信息与客服系统中的投诉记录通过“客户ID”这一实体进行关联,从而形成完整的客户画像,这种整合不仅提升了数据的使用效率,更让数据真正成为企业的核心资产。
构建网络知识图谱的实操路径
构建一个高质量的知识图谱并非一蹴而就,它需要严谨的流程和专业的工具,行业共识认为,一个标准的知识图谱构建流程通常包含数据获取、知识抽取、知识融合、知识存储与知识应用五个阶段。
第一阶段:数据获取与预处理
数据是知识图谱的基石,数据来源通常包括结构化数据库、半结构化网页(如HTML表格)以及非结构化文本(如新闻、文档、社交媒体帖子)。
- 结构化数据:直接来自数据库,清洗难度较低,主要任务是统一字段命名。
- 半结构化数据:需要解析HTML标签或XML结构,提取表格或列表信息。
- 非结构化数据:这是最具挑战性的一部分,需要借助自然语言处理(NLP)技术进行深度挖掘。
在预处理阶段,必须对数据进行去重、清洗和标准化,将“北京”、“北京市”、“首都北京”统一映射为同一个标准实体,这一步看似简单,却直接决定了后续图谱的质量。
第二阶段:知识抽取
知识抽取是从原始数据中提取实体、关系和属性的过程,这是构建网络知识图谱中最核心的技术环节。
实体识别(NER)
实体识别旨在从文本中识别出具有特定意义的实体,如人名、地名、机构名、时间等,基于深度学习的方法(如BERT、BiLSTM-CRF)在实体识别任务中表现优异,能够准确捕捉上下文语境中的实体边界。
关系抽取
关系抽取
旨在识别实体之间的语义关系,在句子“马云创立了阿里巴巴”中,系统需要识别出“马云”和“阿里巴巴”是两个实体,并且它们之间存在“创立”这一关系,常用的方法包括基于模板的规则抽取、基于分类器的监督学习以及基于预训练语言模型的联合抽取。
属性抽取
属性抽取旨在提取实体的特征信息,对于实体“iPhone 15”,系统需要提取其“屏幕尺寸”、“处理器”、“发布时间”等属性,属性抽取通常与实体识别和关系抽取联合进行,以提高整体准确率。
解决构建过程中的常见挑战
尽管技术不断进步,但在实际构建网络知识图谱的过程中,企业仍面临诸多挑战,数据质量、知识更新和计算效率是三大主要障碍。
数据质量与一致性
现实世界中的数据充满了噪声和不一致性,不同来源对同一实体的描述可能不同,甚至存在矛盾,据工信部相关数据显示,超过半数的大型企业在数据治理初期都遇到了数据标准不统一的问题。
为解决这一问题,企业需要建立严格的数据质量标准,并引入知识融合技术,知识融合旨在解决实体对齐、属性冲突和关系冲突等问题,当两个来源分别指出某人的生日为“1980年1月1日”和“1980年1月2日”时,系统需要结合上下文或其他可信来源进行判断,或保留不确定性标记。
动态更新与实时性
世界是动态变化的,知识图谱也需要随之更新,传统的离线构建模式难以满足实时性要求,近年来,流式计算和增量学习技术被引入知识图谱构建流程,使得系统能够实时感知新实体和新关系的出现,并自动更新图谱。
在金融风控场景中,新的欺诈团伙可能随时出现,如果知识图谱不能实时更新,风控系统就无法及时识别这些新兴风险,构建支持增量更新的知识图谱架构已成为行业标配。
未来趋势:与大模型深度融合
随着大语言模型(LLM)的兴起,知识图谱与大模型的结合成为新的研究热点,大模型擅长生成和理解自然语言,但容易产生幻觉;知识图谱擅长提供准确的结构化事实,但缺乏灵活性,两者的结合可以实现优势互补。
RAG架构的应用
检索增强生成(RAG)架构是这一趋势的典型代表,在该架构中,当用户提出问题时,系统首先从知识图谱中检索相关的事实片段,然后将这些片段作为上下文提供给大模型,由大模型生成最终答案,这种方式不仅提高了答案的准确性,还增强了可解释性。
自动化构建与推理
未来的知识图谱构建将更加自动化,借助大模型的语义理解能力,系统可以更准确地从非结构化文本中抽取实体和关系,减少人工标注的成本,基于图谱的推理能力也将得到增强,系统能够发现隐含的知识,为用户提供更深层次的洞察。
Q&A:构建网络知识图谱常见问题解析
构建网络知识图谱需要投入多少成本?
构建网络知识图谱的成本因项目规模和复杂度而异,小型项目可能仅需几万元,主要用于工具许可和少量人工标注;而大型行业级图谱可能需要数百万甚至上千万元,涉及数据采集、清洗、标注、算法研发和系统部署,据行业统计,多数情况下,企业应将预算重点放在数据治理和高质量标注上,因为数据质量直接决定图谱价值。
网络知识图谱与搜索引擎有什么区别?
搜索引擎主要基于关键词匹配和链接分析,返回一系列网页链接;而知识图谱基于实体和关系,直接返回结构化的事实答案,搜索引擎解决的是“找到相关信息”的问题,知识图谱解决的是“理解信息含义”的问题,两者并非替代关系,而是互补关系,现代搜索引擎往往集成了知识图谱以增强答案呈现。
如何评估构建网络知识图谱的效果?
评估知识图谱效果主要依据准确率、召回率和覆盖率三个指标,准确率指抽取出的关系和属性中正确的比例;召回率指所有真实存在的实体和关系中被成功抽取的比例;覆盖率指图谱覆盖的业务领域范围,业内专家指出,除了技术指标,业务指标如搜索点击率、推荐转化率等也是重要的评估维度。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/236429.html