构建Hive数据仓库ETL流程的核心在于明确ODS、DWD、DWS、ADS四层架构,并通过Shell脚本与Hive SQL结合实现自动化调度,从而解决数据孤岛与计算效率低下的问题。
在大数据生态系统中,数据仓库不仅是存储数据的容器,更是企业决策的基石,许多团队在初期往往陷入“重存储、轻治理”的误区,导致数据质量参差不齐,一个健壮的ETL(Extract-Transform-Load)流程,能够确保从原始数据到最终报表的全链路可追溯、可监控,本文将深入解析如何构建一套标准且高效的Hive数据仓库ETL体系,涵盖架构设计、代码实现及调度策略。

Hive数据仓库分层架构设计
业内专家指出,清晰的分层架构是避免数据混乱的第一道防线,传统的扁平化结构会导致逻辑耦合严重,一旦需求变更,牵一发而动全身,我们采用业界公认的四层架构模型,每一层都有明确的职责边界。
ODS层:原始数据保持
ODS(Operational Data Store)层直接对接业务数据库或日志文件,这一层的核心原则是“保持原貌”。
- 数据同步:通常使用Sqoop、DataX或Flume将MySQL、Oracle等关系型数据库的数据全量或增量同步至HDFS。
- 分区策略:按照天(dt)或小时(hour)进行分区,便于后续的数据回溯和清理。
- 格式选择:推荐使用ORC或Parquet格式,这些列式存储格式在压缩率和查询性能上具有显著优势,尤其适合Hive场景。
DWD层:明细数据清洗
DWD(Data Warehouse Detail)层是数据仓库的核心,负责数据的清洗、标准化和维度退化。
- 数据清洗:去除空值、重复值,处理异常数据,将用户年龄字段中的负数或超过150的值标记为NULL。
- 维度退化:将常用的维度属性(如商品名称、分类、品牌)冗余到事实表中,减少后续Join操作,提升查询效率。
- 一致性处理:统一数据字典,确保不同来源的数据在编码、命名上保持一致。
DWS层:轻度汇总数据
DWS(Data Warehouse Summary)层基于DWD层进行轻度汇总,通常按主题域进行聚合。
- 用户行为汇总:统计每个用户的每日访问次数、停留时长、购买金额等。
-
商品销售汇总
:统计每个商品SKU的日销量、销售额、退货率等。 - 宽表构建:构建用户画像宽表、商品属性宽表,为上层应用提供直接可用的数据源。
ADS层:应用数据服务
ADS(Application Data Service)层直接面向应用层,提供高度汇总的指标数据。
- 报表数据:为BI报表提供最终展示数据,如日活用户数(DAU)、月活跃用户数(MAU)、GMV等。
- 接口数据:为前端页面或移动端APP提供API所需的数据支持。
- 性能优化:由于数据量相对较小,可以直接查询,无需复杂的聚合计算。
ETL流程实现与代码规范
有了清晰的架构,接下来需要关注具体的ETL实现,这里以Hive SQL为主,辅以Shell脚本进行流程控制。
数据抽取与加载
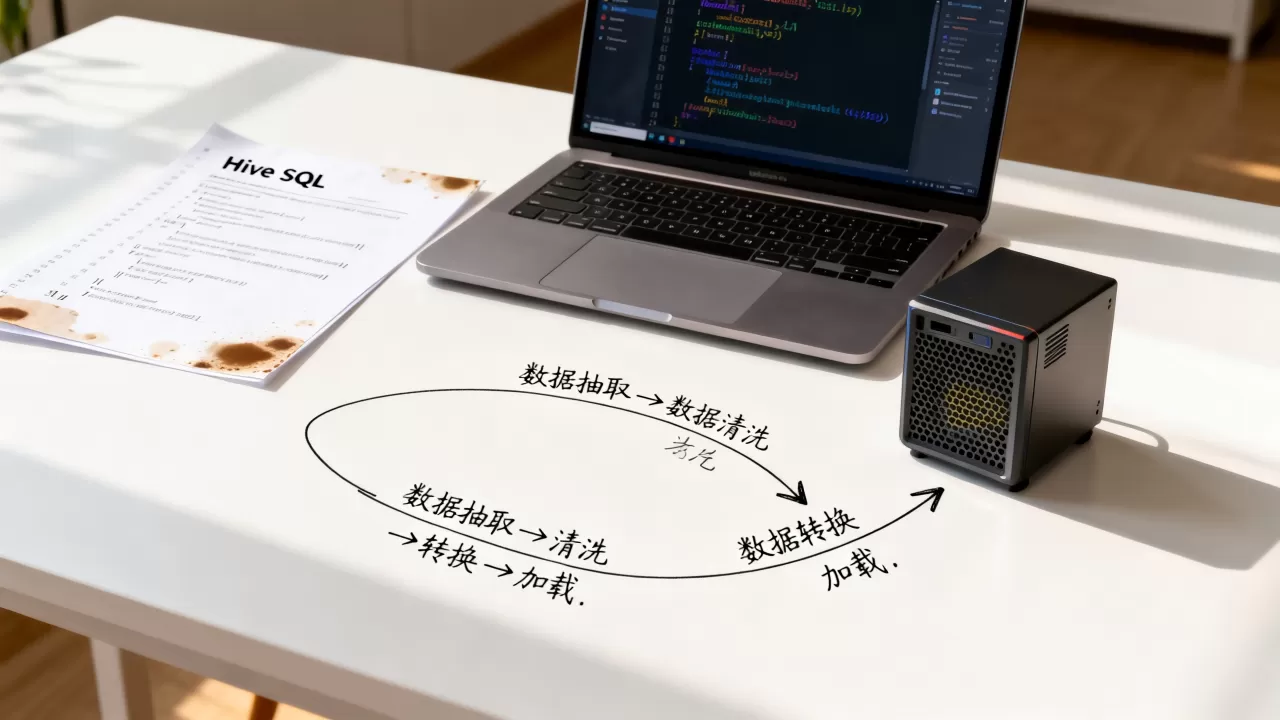
数据抽取阶段主要解决“数据从哪里来”的问题,对于结构化数据,我们通常采用批量同步的方式。
- 全量同步:首次初始化时,将历史数据一次性导入ODS层。
- 增量同步:每日定时任务,仅同步前一天的新增数据。
- 脚本示例:
# 使用Sqoop进行增量导入
sqoop import
--connect jdbc:mysql://host:3306/db
--username user
--password pass
--table orders
--target-dir /warehouse/ods/ods_orders
--fields-terminated-by '01'
--incremental lastmodified
--check-column update_time
--last-value '2026-10-01 00:00:00'
数据转换逻辑
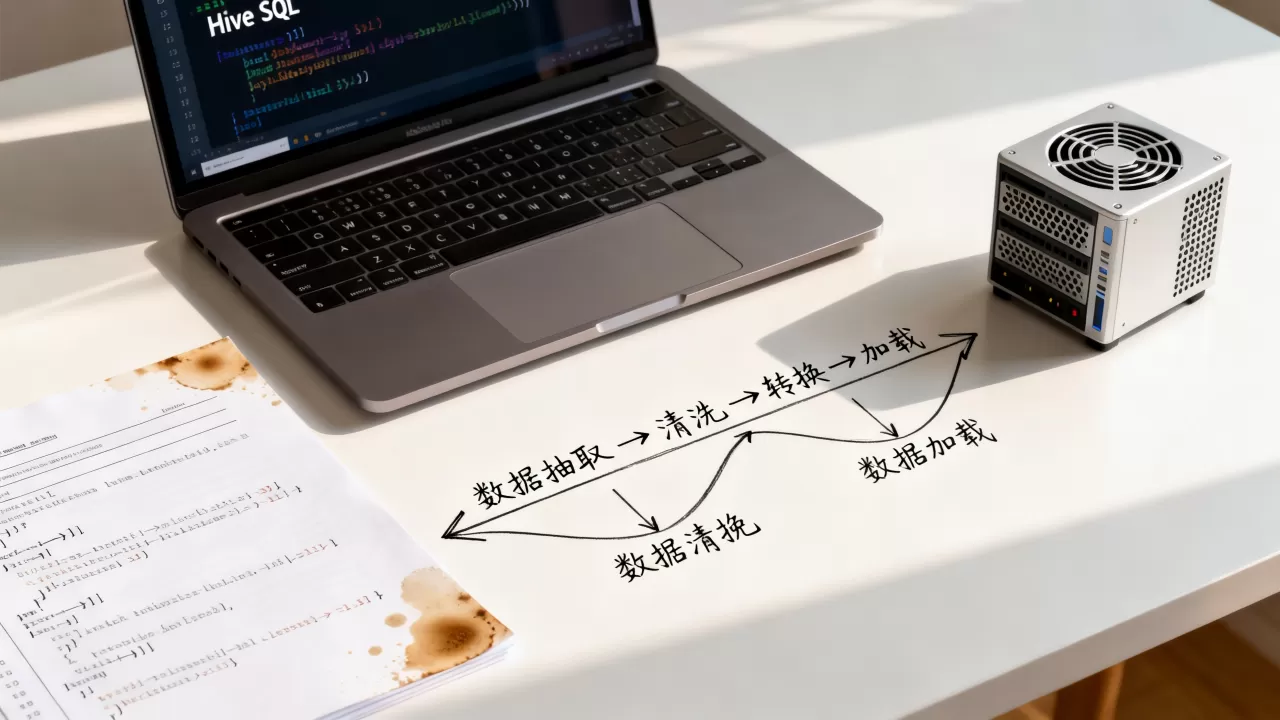
在DWD层,数据转换是重头戏,我们需要编写复杂的SQL逻辑来处理业务规则。
- 去重处理:使用
ROW_NUMBER()窗口函数对重复数据进行标记,只保留最新一条记录。 - 字段映射:通过
CASE WHEN语句实现字段的映射和转换。 - 关联维度:使用
LEFT JOIN将事实表与维度表关联,补充缺失的维度信息。
数据加载与分区管理
数据转换完成后,需要将结果加载到目标表中。
- 动态分区:使用
INSERT OVERWRITE TABLE ... PARTITION语句,根据数据中的分区字段自动创建分区。 - 小文件合并
:在ETL任务结束后,执行
ALTER TABLE ... CONCATENATE命令,合并小文件,提升后续查询性能。
自动化调度与监控体系
手动执行ETL任务既不现实也不可靠,构建一个稳定的调度系统是保障数据准时产出的关键。
调度工具选型
目前主流的调度工具有Apache DolphinScheduler、Airflow和Azkaban,对于Hive生态,DolphinScheduler因其可视化界面和强大的依赖管理能力,成为许多企业的首选。
- 依赖管理:支持复杂的任务依赖关系,如任务A和任务B完成后才能执行任务C。
- 失败重试:配置自动重试机制,应对网络抖动或临时性故障。
- 告警通知:集成邮件、钉钉、企业微信等通知渠道,任务失败时及时通知相关人员。
数据质量监控
数据质量是数据仓库的生命线,我们需要在ETL流程中嵌入质量监控规则。
- 空值检测:检查关键字段是否为空,若比例超过阈值则告警。
- 波动检测:对比昨日与今日的数据量,若波动超过一定比例(如±20%),则触发告警。
- 主键唯一性:检查主键是否重复,确保数据的完整性。
常见问题与优化策略
在实际操作中,团队往往会遇到各种性能瓶颈和问题,以下是几个典型场景及解决方案。
数据倾斜处理
数据倾斜是导致Hive任务运行缓慢的主要原因之一。
- 现象:大部分Task执行很快,个别Task执行极慢,甚至OOM。
- 原因:某些Key的数据量远大于其他Key,导致数据分布不均。
- 解决方案:
- 加盐处理:在Join Key前加上随机前缀,打散数据,然后再进行聚合。
- 参数调整:调整
hive.groupby.skewindata参数,让Hive自动进行两阶段聚合。 - 过滤热点Key:如果某些Key是业务热点(如“未知”用户),可以单独处理或过滤掉。
小文件问题
频繁的插入和删除操作会产生大量小文件,影响NameNode性能和查询效率。
- 解决方案:
- 合并小文件:在ETL任务结束后,执行合并命令。
- 调整输出参数:设置
hive.merge.mapfiles和hive.merge.mapredfiles为true,让Hive在Map-only或Map-Reduce任务结束时自动合并小文件。 - 合理分区:避免分区粒度过细,如按秒分区会导致分区数爆炸。
资源隔离与队列管理
在多租户环境下,资源竞争会导致任务排队等待。
- 队列划分:根据业务重要性划分队列,如“实时队列”、“离线队列”、“测试队列”。
- 资源限制:为每个队列设置最大资源占比,防止某个业务独占集群资源。
- 优先级调度:设置任务优先级,高优先级任务优先获取资源。
Hive数据仓库etl例子常见疑问解答
如何选择合适的Hive数据仓库etl例子中的存储格式?
选择存储格式需权衡查询性能与存储空间,ORC格式在压缩率和查询速度上表现优异,适合大多数OLAP场景,尤其是涉及大量聚合查询时,Parquet格式对嵌套数据结构支持更好,且在Spark生态中兼容性更佳,若数据主要用于列式查询且对压缩率要求高,推荐ORC;若数据包含复杂嵌套结构或需与Spark深度集成,Parquet是更优选择,避免使用TextFile,除非数据仅用于临时传输或调试。
ETL过程中如何处理数据变更历史?
处理数据变更历史通常采用拉链表或快照表策略,拉链表通过增加start_date和end_date字段记录每条记录的有效时间段,适用于维度缓慢变化(SCD Type 2)场景,能追溯历史状态,快照表则每天生成一份完整的全量数据副本,适用于数据量不大且对历史查询要求简单的场景,若需兼顾查询性能与存储成本,可结合使用:近期数据使用拉链表,历史数据归档为快照表。
如何验证Hive数据仓库etl例子中的数据准确性?
数据准确性验证需建立多层校验机制,在ODS层进行源数据与目标数据行数比对,确保数据迁移完整,在DWD层进行关键字段的一致性校验,如金额总和、用户ID唯一性,在ADS层进行业务逻辑校验,如日报表数据与核心业务系统报表数据的一致性比对,可引入数据质量监控平台,自动执行SQL校验规则,发现异常立即告警,确保数据可信。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/234418.html