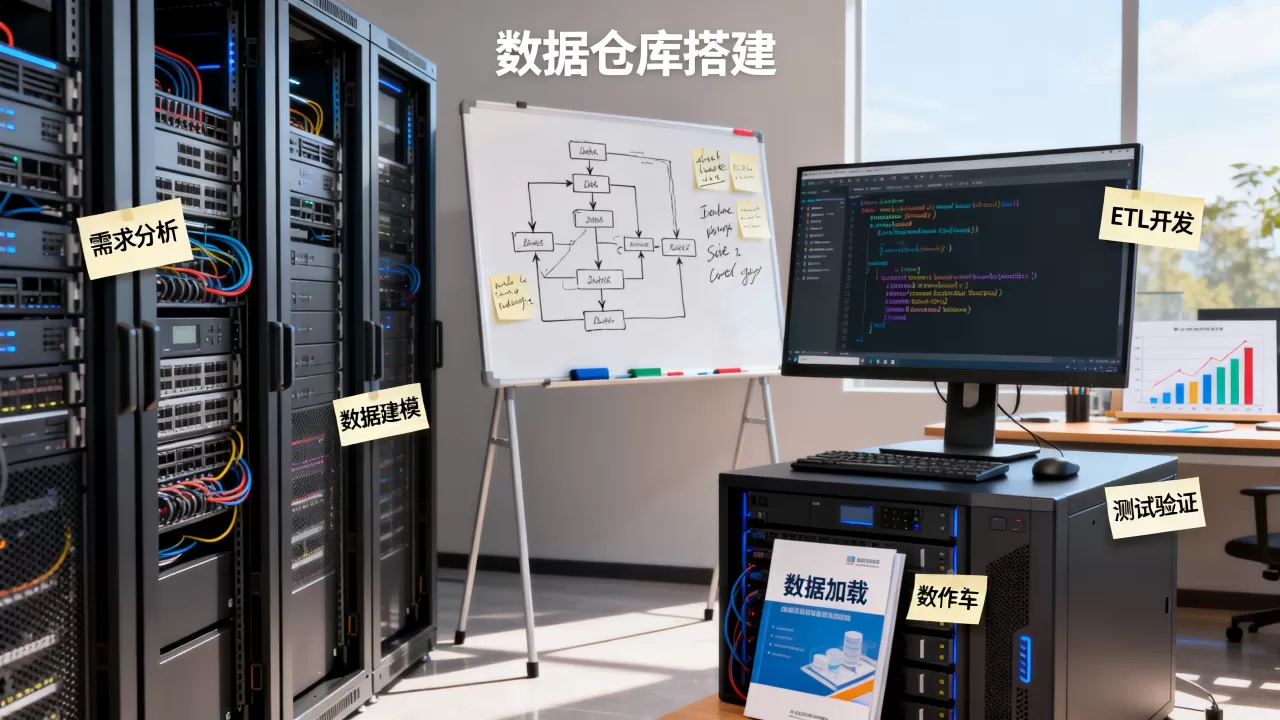
构建数据仓库并非单纯的技术堆砌,而是通过“需求梳理-架构设计-数据集成-开发建模-治理运维”五个核心步骤,将杂乱无章的原始数据转化为可驱动业务决策的高价值资产。
在数字化转型的深水区,企业往往面临“数据多但价值少”的困境,许多团队在初期盲目引入Hadoop或云原生架构,却因缺乏清晰的业务映射,导致后期维护成本高昂且查询缓慢,业内专家指出,成功的数仓建设始于对业务场景的精准洞察,而非技术选型的盲目跟风,以下将深入拆解构建数据仓库的五个关键步骤,帮助企业在复杂的数据环境中建立稳固的基石。
第一步:明确业务需求与指标体系
数据仓库的本质是服务于业务决策,如果脱离业务场景,再先进的架构也只是昂贵的存储库,这一步的核心在于将模糊的业务问题转化为具体的数据需求。
识别关键业务痛点
不同部门对数据的诉求截然不同,销售团队关注转化率与客单价,运营团队看重用户留存与活跃度,财务部门则聚焦于成本核算与利润分析,必须深入一线,通过访谈和调研,梳理出核心业务流程中的断点和盲区,在电商场景中,分析“用户从浏览到下单的流失节点”比单纯统计“总销售额”更具指导意义。
定义核心指标字典
指标口径不一致是数据治理的最大痛点,在构建阶段,需建立统一的指标定义标准。
- 原子指标:如“支付金额”、“访问次数”,不可再分。
- 派生指标:在原子指标基础上加上时间周期、修饰词,如“近30天北京地区新客支付金额”。
- 一致性维度:确保“用户ID”、“商品ID”在所有报表中指向同一实体。
实操建议
建立一份共享的指标字典文档,明确每个指标的计算逻辑、数据来源、更新频率及负责人,这能有效避免“数据打架”现象,为后续建模奠定逻辑基础。
第二步:选择合适的数仓架构与技术栈
架构设计决定了数仓的扩展性、性能和维护成本,当前主流架构已从传统的单机MPP数据库向云原生湖仓一体演进。
传统数仓 vs 湖仓一体
对于大多数中型企业而言,平衡成本与灵活性至关重要。
| 特性 | 传统数仓 (如Teradata, Oracle) | 云原生数仓 (如Snowflake, MaxCompute) | 湖仓一体 (如Delta Lake, Hudi) |
|---|---|---|---|
| 存储成本 | 极高,按节点付费 | 存储计算分离,成本低 | 极低,基于对象存储 |
| 数据结构 | 仅支持结构化数据 | 主要支持结构化,半结构化支持增强 | 支持结构化、半结构化、非结构化 |
| 实时性 | 较弱,通常T+1 | 支持微批处理,近实时 | 支持流式写入,高实时性 |
| 适用场景 | 核心财务、强一致性要求场景 | 通用数据分析、报表展示 | 数据科学、机器学习、全域数据分析 |
技术选型考量因素
- 数据量级:日均增量在TB级以下,传统云数仓即可胜任;PB级以上且包含大量日志、图片数据,建议考虑湖仓一体。
- 团队技能栈:若团队熟悉SQL,云数仓上手最快;若涉及大量Python数据处理,Spark生态更合适。
- 预算限制:初创企业可优先采用Serverless架构,按查询量付费,避免前期硬件投入过大。
第三步:数据集成与ETL流程构建
数据集成是将分散在各业务系统(如CRM、ERP、日志服务器)中的数据抽取、清洗并加载到数仓的过程,这是数仓建设的“脏活累活”,也是质量控制的关卡。
抽取策略:全量与增量
- 全量抽取:适用于数据量小、变化频繁或无时间戳的表。
- 增量抽取:利用时间戳、自增ID或CDC(变更数据捕获)技术,仅同步变更数据,据统计,采用增量同步可将数据同步时间缩短90%以上,显著降低源系统压力。
清洗与转换规则
原始数据往往充满噪声,ETL过程中需执行严格的清洗规则:
- 空值处理:数值型填0,文本型填“未知”或根据业务逻辑推断。
- 格式统一:日期格式标准化为YYYY-MM-DD,手机号去除特殊字符。
- 异常值过滤:识别并剔除明显违背业务常识的数据,如年龄超过150岁、金额为负数等。
常见陷阱
避免在ETL过程中进行复杂的业务逻辑计算,尽量保持ETL层的轻量级,将复杂逻辑下沉至数仓建模层,以提高代码的可维护性和复用性。
第四步:分层建模与维度设计
建模是数仓建设的核心灵魂,合理的分层架构能解耦业务逻辑,提高数据复用率,降低重复开发成本,业界通用的分层模型包括ODS、DWD、DWS和ADS。
ODS层:操作数据存储
保持与源系统数据结构一致,仅做轻微清洗(如去重、格式标准化),保留历史快照,这一层是数据的“原始档案库”。
DWD层:明细数据层
进行维度退化、数据清洗和规范化处理,将订单表中的用户ID关联出用户名、性别、年龄段等维度属性,形成宽表,这一层是数仓的“基石”,强调一致性。
DWS层:汇总数据层
按主题域(如用户、商品、交易)进行轻度汇总,构建“用户日粒度行为汇总表”,包含该用户当天的访问次数、购买金额、浏览商品数等,这一层极大提升了查询效率,避免每次报表生成都扫描海量明细数据。
ADS层:应用数据层
直接面向最终应用,如BI报表、数据大屏、推荐系统接口,数据经过高度聚合,格式固定,读取速度极快。
维度建模实战
采用星型模型或雪花模型,星型模型查询性能更优,适合大多数分析场景;雪花模型节省存储空间,但查询复杂,建议优先使用星型模型,通过冗余维度来换取查询性能。
第五步:数据治理与持续运维
数仓不是一次性项目,而是一个持续演进的生命体,随着业务扩张,数据资产会迅速膨胀,若无有效治理,数仓将沦为“数据沼泽”。
元数据管理
建立数据地图,记录每张表的结构、血缘关系、负责人及更新频率,当源系统字段变更时,能快速定位受影响的上游报表,实现“牵一发而动全身”的风险预警。
数据质量监控
部署自动化监控规则,对关键指标进行每日巡检。
- 完整性:检查主键是否重复,必填字段是否为空。
- 准确性:对比数仓数据与源系统数据,误差率超过阈值自动告警。
- 及时性:监控ETL任务运行时间,延迟超过SLA标准立即通知。
成本优化
云数仓环境下,存储和计算成本与数据量及查询频率强相关,定期归档冷数据,删除无用临时表,优化慢查询SQL,是降低运营成本的必要手段。
构建数据仓库常见问题解答
中小企业是否需要自建数据仓库?
多数情况下,中小企业初期无需自建重型数仓,若数据量在百万级以下,且业务逻辑相对简单,可直接使用BI工具连接业务数据库,或通过SaaS化数据平台解决,只有当数据量达到千万级、多源异构数据融合需求强烈、且对数据安全性有极高要求时,才建议投入资源构建独立数仓。
数据仓库与数据湖的主要区别是什么?
数据仓库主要存储经过清洗、结构化处理的数据,服务于确定的分析场景,强调ACID事务一致性和高性能查询;数据湖存储原始数据(包括结构化、半结构化、非结构化),服务于探索性分析和机器学习,强调存储成本低和灵活性,两者并非替代关系,而是互补关系,现代架构常将二者结合,形成湖仓一体。
数据仓库建设周期通常需要多久?
建设周期取决于业务复杂度和数据规模,一个标准的MVP(最小可行性产品)版本,涵盖核心业务域和基础报表,通常需2-3个月完成从需求到上线的全过程,若涉及全企业级数据打通、复杂指标体系重构及历史数据迁移,周期可能延长至6-12个月,建议采用敏捷迭代方式,先上线核心模块,再逐步扩展。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/205816.html