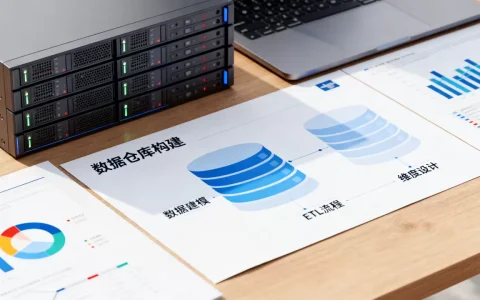
构建数据仓库的核心在于通过ETL流程将分散的业务数据清洗、整合并存储,从而为前端分析提供统一、准确且高效的数据服务,而非简单的大数据存储。
很多企业在数字化转型初期,往往混淆了“数据湖”与“数据仓库”的概念,导致后期数据治理成本极高,数据仓库(Data Warehouse, DW)的本质是面向主题的、集成的、相对稳定的、反映历史变化的数据集合,它服务于管理层决策,要搭建一个符合现代企业需求的数据仓库,必须理清从数据源到数据应用的完整链路。
数据仓库构建的核心架构与流程解析
构建数据仓库并非一蹴而就,它需要遵循严格的分层架构设计,业内专家指出,合理的分层能有效降低数据耦合度,提升维护效率,典型的现代数据仓库架构通常分为四层:ODS层(操作数据存储)、DWD层(明细数据层)、DWS层(汇总数据层)和应用数据层(ADS)。
数据采集与接入层:打破数据孤岛
数据仓库的起点是数据源,现代企业的数据来源极其复杂,包括关系型数据库(如MySQL、Oracle)、日志文件、API接口、甚至第三方SaaS平台的数据。
- 实时数据接入:对于电商交易、用户行为日志等对时效性要求极高的场景,通常采用Kafka等消息队列进行缓冲,再通过Flink或Spark Streaming进行实时计算。
- 离线数据同步:对于历史数据或T+1报表需求,常用DataX、Sqoop或Canal进行批量或增量同步。
在此阶段,关键挑战在于解决“数据孤岛”问题,某大型零售企业曾面临POS系统、CRM系统和电商平台数据格式不一的问题,导致无法统一计算用户全生命周期价值,通过建立统一的数据接入规范,将异构数据标准化后导入ODS层,是后续所有分析的基础。
数据清洗与整合层:确保数据质量
原始数据往往充满噪声、缺失值和重复项,DWD层(Data Warehouse Detail)的核心任务就是“清洗”和“标准化”。
- 数据清洗:去除空值、修正异常值(如年龄为负数)、统一日期格式。
- 数据脱敏:对手机号、身份证等敏感信息进行加密或掩码处理,符合《个人信息保护法》要求。
- 维度建模:这是数据仓库设计的灵魂,采用星型模型或雪花模型,将数据划分为“事实表”和“维度表”。
以电商场景为例,事实表记录每一笔订单的交易金额、数量,维度表则包含时间、商品、用户、店铺等信息,这种设计使得查询性能大幅提升,因为维度表通常较小且相对静态,而事实表虽然庞大,但结构清晰。
技术选型与工具链对比分析
选择合适的技术栈是构建数据仓库的关键决策,2026年的技术生态中,云原生和数据湖仓一体成为主流趋势。
传统数仓 vs 云原生数仓:成本与性能权衡
企业在选型时,常纠结于传统本地部署与云原生方案的选择。
| 维度 | 传统本地数仓 (如Oracle Exadata) | 云原生数仓 (如Snowflake, MaxCompute) |
|---|---|---|
| 初始投入 | 高昂,需购买硬件及软件授权 | 低,按需付费,无需维护硬件 |
| 扩展性 | 垂直扩展为主,扩容周期长 | 弹性伸缩,秒级扩容,支持PB级数据 |
| 运维复杂度 | 高,需专业DBA团队维护 | 低,厂商负责底层维护,聚焦SQL开发 |
| 适用场景 | 对数据主权极度敏感、网络受限的国企 | 互联网企业、快速迭代的初创公司 |
行业共识认为,对于大多数中小企业而言,云原生数仓能显著降低TCO(总拥有成本),使用Hive或Spark on Kubernetes构建的开源方案,虽然初期开发成本高,但长期运维成本可控;而商业化的云数仓则适合希望快速上线、缺乏底层技术团队的企业。
实时数仓与离线数仓的融合实践
过去,实时和离线是两套独立的系统,导致数据口径不一致,现在的最佳实践是“湖仓一体”或“流批一体”。
- 离线处理:使用Spark SQL或Hive进行T+1的全量或增量计算,保证数据的准确性和一致性。
- 实时处理:使用Flink + Kafka + HBase/ClickHouse,实现秒级数据更新,用于实时大屏、风控拦截等场景。
通过统一的数据模型层(DWS),确保实时和离线计算出的指标口径一致,某金融科技公司通过构建统一的指标字典,使得实时风控引擎和离线反欺诈模型使用的“用户逾期率”指标完全一致,避免了业务决策的冲突。
数据治理与价值落地:从数据到洞察
构建数据仓库的最终目的是应用,如果数据无法被业务人员轻松理解和使用,那么再复杂的架构也是徒劳。
数据资产管理与元数据管理
数据资产就像企业的图书,需要编目才能被检索,元数据管理包括技术元数据(表结构、字段类型)、业务元数据(指标定义、业务含义)和操作元数据(作业运行日志)。
- 数据血缘分析:当某个报表数据异常时,能快速追溯是哪张源表、哪个ETL任务出了问题。
- 数据质量监控:设置规则,如“主键唯一性”、“非空检查”、“波动率阈值”,一旦数据异常立即报警。
据工信部相关数据表明,实施完善数据治理的企业,其数据查询响应速度平均提升40%以上,数据信任度显著增强。
BI可视化与自助式分析
数据仓库建设完成后,需通过BI工具(如Tableau、Power BI、FineBI)将数据转化为可视化图表。
- 固定报表:针对管理层每日关注的KPI,生成自动化日报、周报。
- 自助探索:允许业务人员通过拖拽方式,基于DWS层的数据进行多维分析,无需依赖IT部门写SQL。
市场部门可以通过自助分析,快速查看不同渠道、不同地区的ROI(投资回报率),从而及时调整广告投放策略,这种“数据赋能业务”的模式,是数据仓库价值最大化的体现。
常见误区与避坑指南
在构建数据仓库的过程中,许多团队容易陷入以下误区,导致项目延期或失败。
追求大而全,忽视场景驱动
不要试图一次性构建涵盖所有业务的数据仓库,应先聚焦核心业务场景,如“销售分析”或“用户画像”,打通最小闭环,再逐步扩展。
重技术轻治理,数据垃圾进,垃圾出
如果源系统数据质量差,ETL清洗逻辑复杂且脆弱,最终的数据仓库将不可信,必须建立数据质量闭环,从源头规范数据录入。
忽视数据安全与权限管控
不同部门对数据的可见范围不同,需实施细粒度的权限控制,如行级权限(某销售只能看自己辖区数据)和列级权限(HR能看到薪资,其他部门不可见)。
数据仓库构建常见问题解答
数据仓库构建中如何处理历史数据变更?
处理历史数据变更通常采用缓慢变化维(SCD)技术,SCD Type 1是直接覆盖旧数据,不保留历史;SCD Type 2是新增一行记录,保留历史版本,通过有效起止时间标识当前版本,对于关键业务指标,建议采用SCD Type 2,以确保历史报表数据的可追溯性和准确性。
数据仓库与数据湖有什么区别?
数据湖存储原始、非结构化数据,格式灵活,成本低,适合机器学习和深度探索;数据仓库存储结构化、清洗后的数据,模式固定,查询速度快,适合商业智能和报表分析,现代架构通常将两者结合,形成“湖仓一体”,利用数据湖的存储优势和数据仓库的计算治理优势。
构建数据仓库需要多长时间?
项目周期取决于业务复杂度和数据规模,小型企业或单一业务线的数仓搭建,通常在2-3个月内可完成核心模块上线;大型集团级数仓涉及多系统整合,可能需要6-12个月甚至更久,建议采用敏捷迭代方式,先上线最小可行产品(MVP),再逐步完善。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/205595.html