构建湖仓一体数据仓库的核心在于打破数据湖与数据仓库的边界,通过统一存储层实现数据的低成本存储与高性能分析,从而解决传统架构中数据孤岛与治理难题。
为什么传统数据架构正在失效?
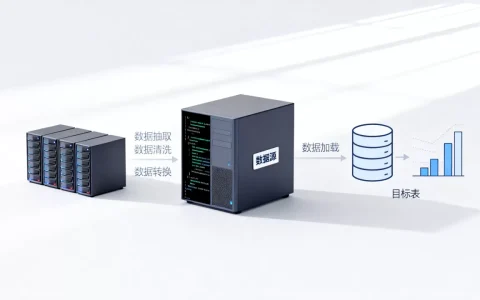
过去十年,企业数据架构通常遵循“数据湖+数据仓库”的双层模式,数据工程师将原始数据倒入廉价的数据湖,经过清洗转换后,再加载到高成本的数仓中进行报表分析,这种模式看似完美,实则暗藏危机。
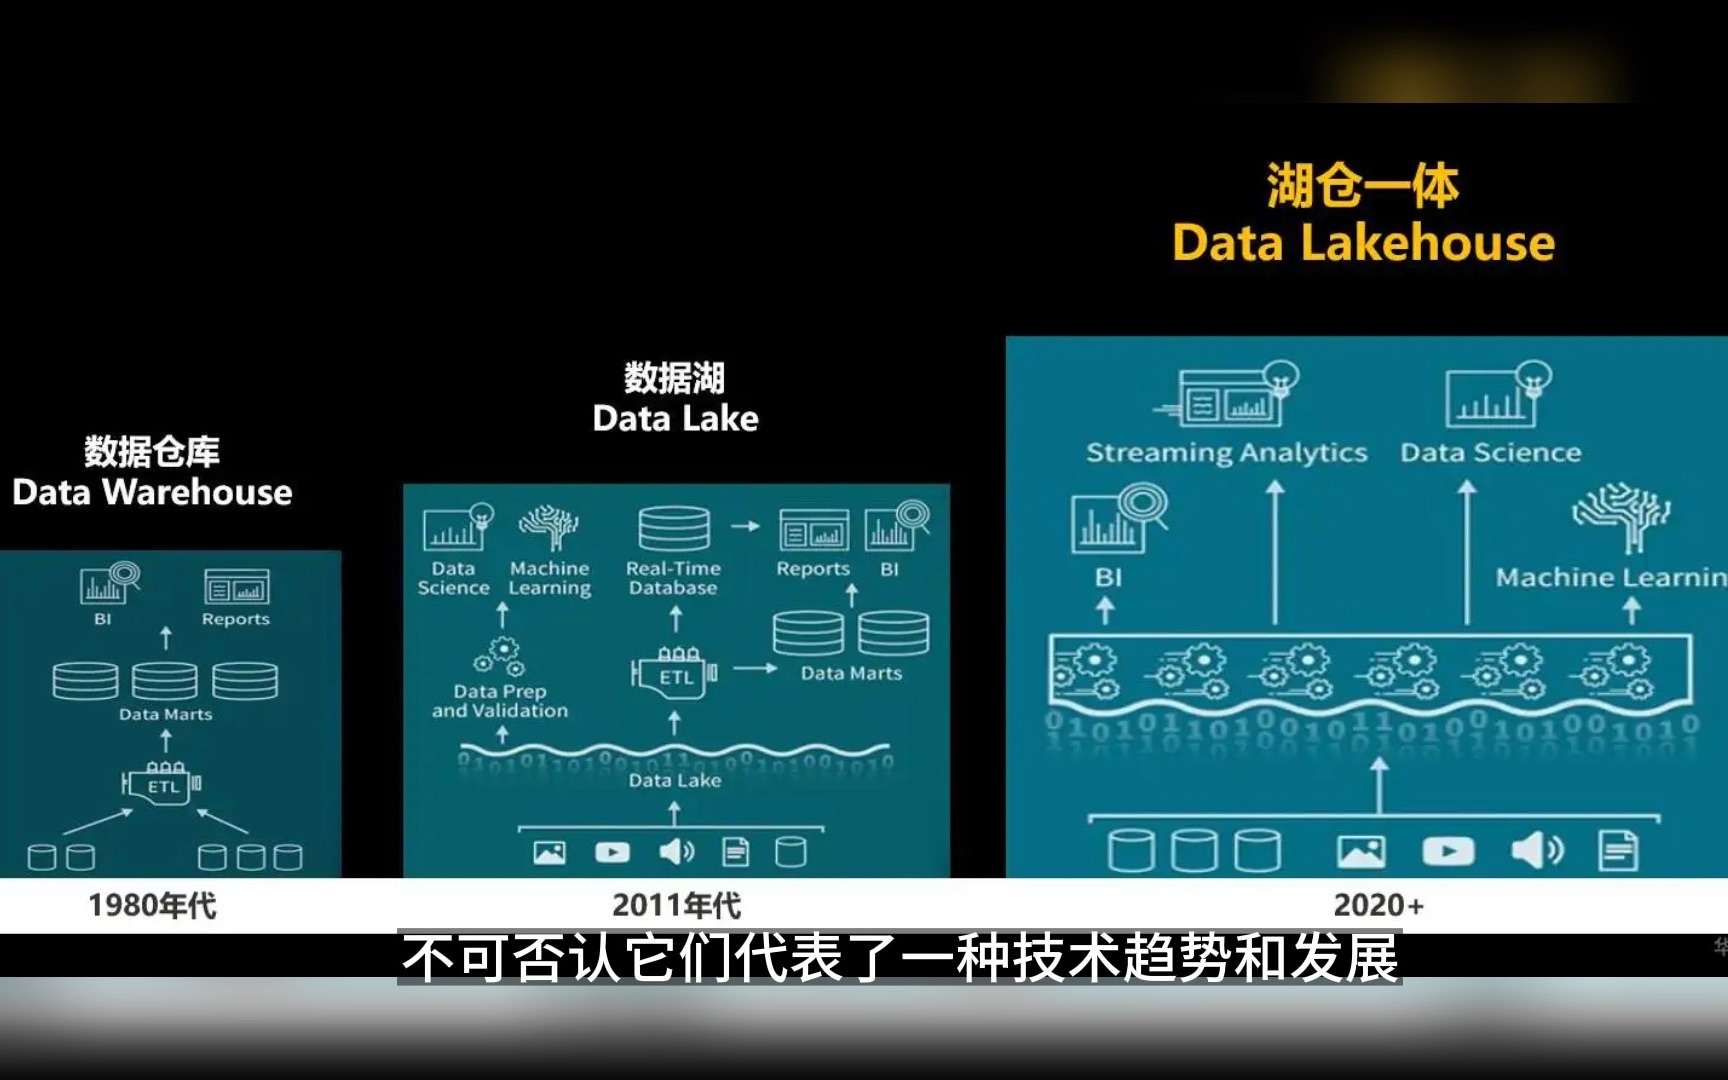
业内专家指出,这种分离式架构导致了严重的“数据割裂”,数据在湖和仓之间反复搬运,不仅增加了延迟,还引发了版本混乱,当业务部门询问“为什么昨天的销售数据和今天的对不上”时,IT团队往往需要花费数天时间排查数据链路,因为两个系统的数据定义、更新频率和元数据管理完全独立。
数据孤岛带来的具体痛点
在实际业务场景中,这种架构缺陷主要体现在三个方面:
- 延迟高:从数据产生到可分析,往往需要T+1甚至更久,无法支持实时决策。
- 成本高:为了追求查询性能,企业不得不购买昂贵的专有硬件或云服务,存储成本居高不下。
- 治理难:数据质量参差不齐,缺乏统一的数据血缘追踪,导致“垃圾进,垃圾出”。
湖仓一体的核心架构解析
湖仓一体(Lakehouse)并非简单的技术叠加,而是一种架构范式的重构,它保留了数据湖的低成本、开放性和灵活性,同时引入了数据仓库的结构化管理、ACID事务支持和高性能查询能力。
统一存储层:Open Table Formats
实现湖仓一体的关键技术基石是开放表格式,如Apache Iceberg、Hudi或Delta Lake,这些格式允许数据以标准文件形式存储在对象存储(如S3、OSS)中,同时提供类似数据库的事务管理能力。
操作路径示例
以Apache Iceberg为例,其核心优势在于元数据与数据的分离,当数据写入时,系统会自动管理快照(Snapshot),确保每次查询都能获得一致性的视图,这意味着开发者无需关心底层文件的合并或清理,只需关注数据逻辑。
- 步骤一:配置对象存储桶作为底层存储介质。
- 步骤二:使用支持Iceberg协议的引擎(如Spark、Trino)创建表结构。
- 步骤三:直接写入原始数据,系统自动维护元数据索引。
计算存储分离:弹性与成本的双赢
传统数仓通常将计算与存储绑定,导致资源利用率低下,湖仓一体架构天然支持计算与存储分离,存储层使用廉价的对象存储,计算层则根据查询负载动态伸缩。
据统计,采用计算存储分离架构的企业,其基础设施成本通常能降低30%-50%,这种弹性使得企业可以在夜间批量处理大规模ETL任务,而在白天仅启动少量计算节点服务于实时报表,极大提升了资源效率。
如何落地湖仓一体架构?
落地湖仓一体并非一蹴而就,需要结合企业现有的技术栈和业务需求进行渐进式改造。
选型对比:技术栈评估
在选择具体技术组件时,需考虑团队技能储备和现有基础设施。
| 维度 | 传统数仓 | 数据湖 | 湖仓一体 |
|---|---|---|---|
| 存储成本 | 高 | 低 | 极低 |
| 查询性能 | 极高 | 低 | 高(接近数仓) |
| 数据一致性 | 强ACID | 弱/无 | 强ACID |
| 适用场景 | 结构化报表 | 机器学习/原始数据 | 全场景通用 |
实施步骤:从POC到生产
第一阶段:数据入湖与标准化
将所有原始数据(包括日志、业务库Binlog、IoT数据)统一接入对象存储,利用Spark或Flink进行初步清洗,并采用Iceberg等格式进行结构化存储,此阶段重点在于建立统一的数据目录,确保数据可发现。
第二阶段:构建统一查询引擎
部署Trino或Presto等SQL引擎,直接对接底层Iceberg表,业务分析师可以直接使用SQL查询原始数据,无需经过复杂的ETL过程,这一步骤能显著缩短数据从产生到可用的时间窗口。
第三阶段:引入数据治理与权限控制
随着数据量的增长,治理变得至关重要,集成Apache Ranger或AWS Glue Data Catalog,实施细粒度的权限控制,确保不同部门只能访问其授权的数据范围,同时记录所有数据访问日志,满足合规要求。
常见误区与避坑指南
许多企业在尝试湖仓一体时容易陷入误区,导致项目延期或效果不佳。
认为湖仓一体可以完全替代数仓
虽然湖仓一体功能强大,但在超大规模并发、极低延迟要求的OLAP场景下,专用MPP数据库(如ClickHouse、Doris)仍具有性能优势,建议采用“湖仓一体为主,专用引擎为辅”的混合架构,对于实时大屏或高并发查询,可将湖仓中的聚合数据同步至专用引擎。
忽视数据质量治理
技术架构的升级不能掩盖数据质量的短板,如果原始数据本身存在缺失、错误或不一致,湖仓一体只会加速这些问题的传播,必须在数据入湖环节引入数据质量监控规则,如非空检查、值域校验等,确保“进湖即高质量”。
过度追求技术先进性
不要盲目追求最新的技术栈,选择团队熟悉且社区活跃的技术组件更为重要,如果团队精通Hadoop生态,基于Hive+Iceberg的方案可能比全新的Serverless方案更易于维护。
行业趋势与未来展望
随着AI大模型的兴起,湖仓一体正成为AI基础设施的核心组成部分。
AI与湖仓的深度融合
大模型训练需要海量的高质量数据,湖仓一体提供的统一数据视图,使得数据科学家可以直接在原始数据上进行特征工程,无需将数据复制多份,这种“数据不动,计算动”的模式,极大地简化了AI数据流水线。
实时化与智能化
未来的湖仓一体将更加注重实时处理能力,通过引入流批一体引擎,实现毫秒级的数据更新,结合元数据自动管理,系统将能够自动推荐数据分区策略、索引优化方案,降低运维复杂度。
湖仓一体数据仓库常见问题解答
湖仓一体数据仓库适合中小企业吗?
适合,中小企业往往缺乏专门的数据团队,传统数仓的高昂维护成本是巨大负担,湖仓一体基于开源生态,部署灵活,且对象存储按需付费,初期投入低,通过Serverless查询引擎,中小企业无需购买昂贵服务器即可享受高性能分析能力。
如何保证湖仓一体中的数据安全性?
安全性依赖于多层防护机制,首先在存储层启用加密,确保静态数据安全;其次在传输层使用TLS加密;最后在访问层实施基于角色的访问控制(RBAC),利用Iceberg的时间旅行功能,可以追溯数据变更历史,防止误删或恶意篡改。
湖仓一体与传统数据仓库价格对比如何?
在长期运营成本上,湖仓一体通常更具优势,传统数仓需要预置硬件或支付高额云服务费用,且扩容困难,湖仓一体利用对象存储,存储成本仅为传统数仓的1/10左右,计算资源按需弹性伸缩,避免了资源闲置浪费,对于数据量大但查询频率不高的场景,湖仓一体的性价比显著更高。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/205438.html