构建数据仓库的核心在于从“数据孤岛”向“统一事实源”转型,通过分层架构(ODS-DWD-DWS-ADS)实现数据的清洗、整合与价值释放,而非简单的数据搬运。
很多企业在数字化转型初期,常陷入“有数据无价值”的困境,业务部门抱怨报表慢、数据不准,技术部门则疲于应付各种临时取数需求,这背后的根本原因,往往是缺乏一套科学、规范的数据仓库体系,数据仓库不是数据库的简单复制,而是一个面向主题、集成、相对稳定且反映历史变化的数据集合,它像是一个企业的“中央厨房”,将原材料(原始数据)经过清洗、切配、烹饪(加工处理),最终端出符合不同食客口味(业务场景)的成品菜(数据应用)。
数据仓库建设的核心架构与分层逻辑
业内专家指出,一个健壮的数据仓库必须遵循清晰的层次划分,这种分层设计不仅降低了系统耦合度,还使得数据血缘清晰可追溯,目前主流的分层架构通常包含四层,每一层都有明确的职责边界。
原始数据层(ODS):数据的“保鲜库”
这一层直接对接业务系统,如MySQL、Oracle、日志文件等,其核心原则是“保持原貌”。
- 全量与增量同步:对于历史数据,通常进行全量备份;对于实时性要求高的场景,采用增量同步机制。
- 数据隔离:ODS层严禁进行任何业务逻辑处理,确保原始数据的完整性,一旦业务系统表结构变更,OD层只需调整映射关系,不影响上层逻辑。
- 存储策略:考虑到成本,ODS层数据通常保留较短时间(如3-6个月),过期数据可归档或删除。
明细数据层(DWD):数据的“净菜间”
DWD层是数据仓库的核心,负责数据的清洗、标准化和维度退化,这里是解决“数据脏乱差”的关键环节。
- 数据清洗:去除重复值、处理缺失值、修正异常格式,将手机号中的空格去除,统一日期格式为
YYYY-MM-DD
- 维度退化:将高频使用的维度属性(如用户姓名、城市名称)冗余到事实表中,减少后续关联查询,提升查询性能。
- 一致性规范:统一编码体系,所有渠道来源统一标识为
APP、H5、小程序,避免app、App、APP混用导致统计偏差。
汇总数据层(DWS):数据的“半成品库”
DWS层基于DWD层,按照主题域进行轻度汇总,这一层旨在提升查询效率,避免每次查询都从海量明细数据中扫描。
- 用户主题:构建用户行为宽表,包含用户的基本属性、最近一次访问时间、累计消费金额等。
- 商品主题:构建商品销售宽表,包含商品的类目、品牌、销量、库存周转率等指标。
- 时间粒度:通常提供日、周、月等多粒度汇总,满足不同管理层级的查看需求。
应用数据层(ADS):数据的“成品菜”
ADS层直接面向应用,为报表、大屏、API接口提供数据支持。
- 高度聚合:数据已经过高度计算,查询速度极快,通常以宽表形式存在。
- 业务导向:每个表对应具体的业务场景,如“双11实时销售大屏”、“月度经营分析报告”。
- 数据更新:根据业务需求,可以是T+1离线更新,也可以是分钟级实时推送。
数据仓库建设的关键技术选型与实施路径
在确定了架构后,如何选择合适的技术栈并落地实施,是决定项目成败的关键,不同的业务规模和数据体量,对技术选型的要求截然不同。
计算引擎的选择:批流一体趋势
传统的Hadoop生态(Hive+MapReduce)虽然稳定,但实时性较差,近年来,随着云原生技术的发展,越来越多的企业转向更高效的引擎。
- 离线计算:Apache Hive和Apache Spark依然是主流,Spark因其内存计算特性,在处理大规模数据时速度远超Hive。
- 实时计算:Apache Flink成为实时数仓的首选,它支持低延迟、高吞吐的事件驱动处理,能够处理每秒百万级的数据流。
- 云原生方案:对于初创企业或中小团队,直接使用阿里云MaxCompute、腾讯云CDW或AWS Redshift等托管服务,可以大幅降低运维成本。
存储引擎的演进:从HDFS到对象存储
存储层的变化直接影响了数据仓库的成本和性能。
- HDFS:传统大数据存储,适合非结构化数据,但扩展性受限。
- 对象存储(OSS/S3):目前的主流选择,它与计算引擎解耦,实现了存储和计算的弹性伸缩,据行业共识认为,采用存算分离架构的企业,其IT基础设施成本可降低约30%-50%。
- 数据湖仓一体:结合数据湖的灵活性和数据仓库的管理能力,支持结构化、半结构化和非结构化数据的统一存储与分析。
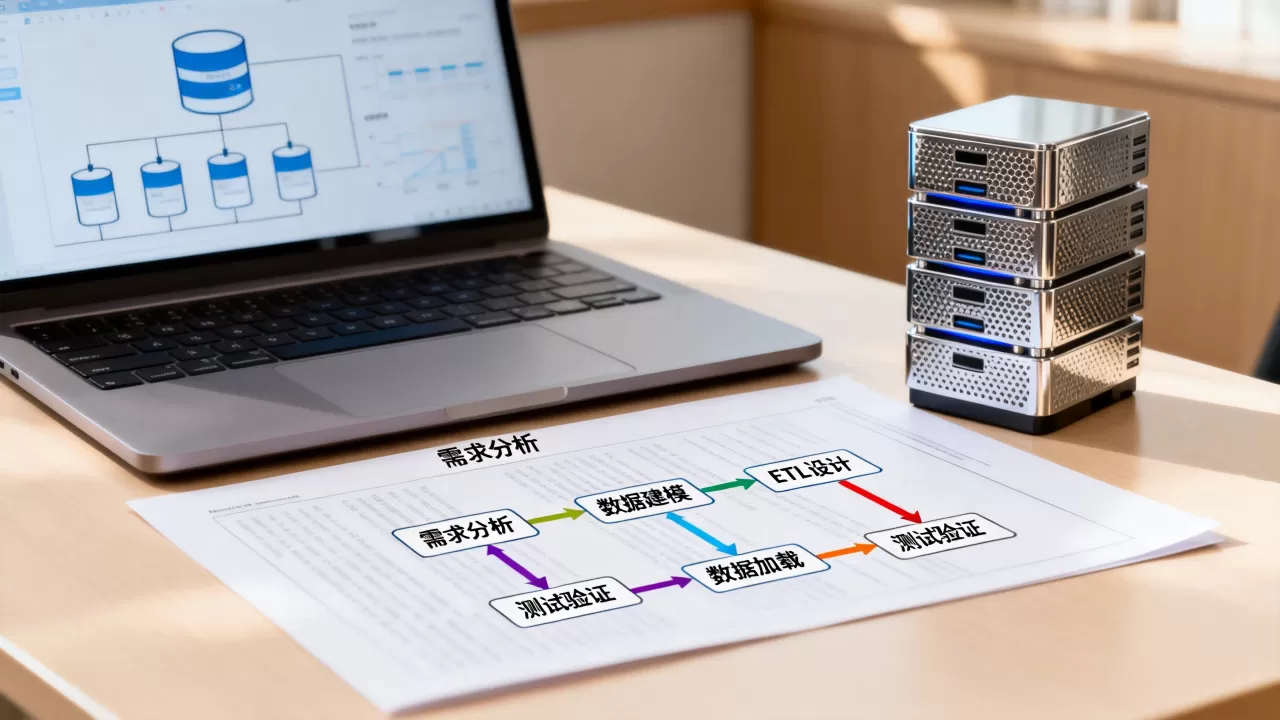
实施步骤:从需求到上线的闭环
数据仓库建设不是一蹴而就的,需要遵循敏捷迭代的原则。
- 需求调研:与业务部门深入沟通,明确核心指标(如GMV、DAU、转化率)的定义和计算口径。
- 模型设计:基于维度建模理论,设计星型模型或雪花模型,确保模型的可扩展性,避免过度设计。
- 数据开发:编写ETL脚本,实现数据从ODS到ADS的全链路流转。
- 数据测试:进行数据一致性校验、准确性测试和性能测试。
- 上线运维:部署监控告警机制,确保任务按时执行,数据质量达标。
常见误区与避坑指南
在实际操作中,许多团队容易陷入一些常见的误区,导致项目延期或效果不佳。
过度追求技术先进性
不要盲目跟风使用最新的技术栈,如果业务数据量不大,复杂的Flink实时链路可能得不偿失,选择合适的技术,而非最贵的技术。
忽视数据治理
数据仓库建成后,如果缺乏治理,很快会退化为“数据沼泽”,必须建立数据质量监控体系,对空值、重复值、波动异常进行实时告警。
业务与技术脱节
数据仓库的价值在于服务业务,技术人员不能闭门造车,必须深入业务场景,理解指标背后的业务含义。“活跃用户”的定义,在电商、社交和内容平台中可能完全不同。
Q&A:数据仓库建设常见问题解析
数据仓库与数据湖有什么区别?
数据仓库主要存储经过清洗、结构化的高质量数据,适合结构化查询和分析,强调数据的准确性和一致性,通常采用列式存储,数据湖则存储原始数据,包括结构化、半结构化和非结构化数据,适合机器学习和深度探索,强调数据的灵活性和扩展性,两者并非对立,而是互补关系,现代架构倾向于“湖仓一体”,即在一个平台上同时支持两种模式。
如何保证数据仓库中的数据准确性?
保证数据准确性需要从源头到应用的全链路管控,在ETL过程中建立严格的数据校验规则,如主键唯一性检查、数值范围检查,建立数据血缘地图,当发现数据异常时,能快速定位问题源头,定期开展数据质量巡检,对比关键指标的历史趋势,发现异常波动及时排查。
数据仓库建设需要多长时间?
数据仓库的建设周期取决于企业的数据规模、业务复杂度和团队能力,对于小型企业,一个基础的数据仓库可能在1-2个月内完成初步搭建,对于中大型企业,涉及多系统整合和复杂指标体系,通常需要3-6个月甚至更长时间,建议采用敏捷开发模式,先上线核心业务模块,再逐步迭代完善,以快速体现数据价值。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/205311.html