构建湖仓一体数据仓库的核心在于打破数据湖与数据仓库的孤岛,通过统一存储层实现低成本存储与高性能分析的结合,从而解决传统架构中数据延迟高、维护复杂及成本高昂的问题。
在数字化转型的深水区,企业面临的不再仅仅是“有没有数据”的问题,而是“如何用好数据”的难题,传统的做法往往是将结构化数据存入关系型数据库,非结构化数据扔进数据湖,结果导致数据流转像接力赛一样频繁且容易出错,湖仓一体(Lakehouse)架构应运而生,它试图用一套系统同时满足数据仓库的ACID事务特性和数据湖的灵活扩展性,这不仅仅是技术的堆叠,更是数据治理理念的革新。
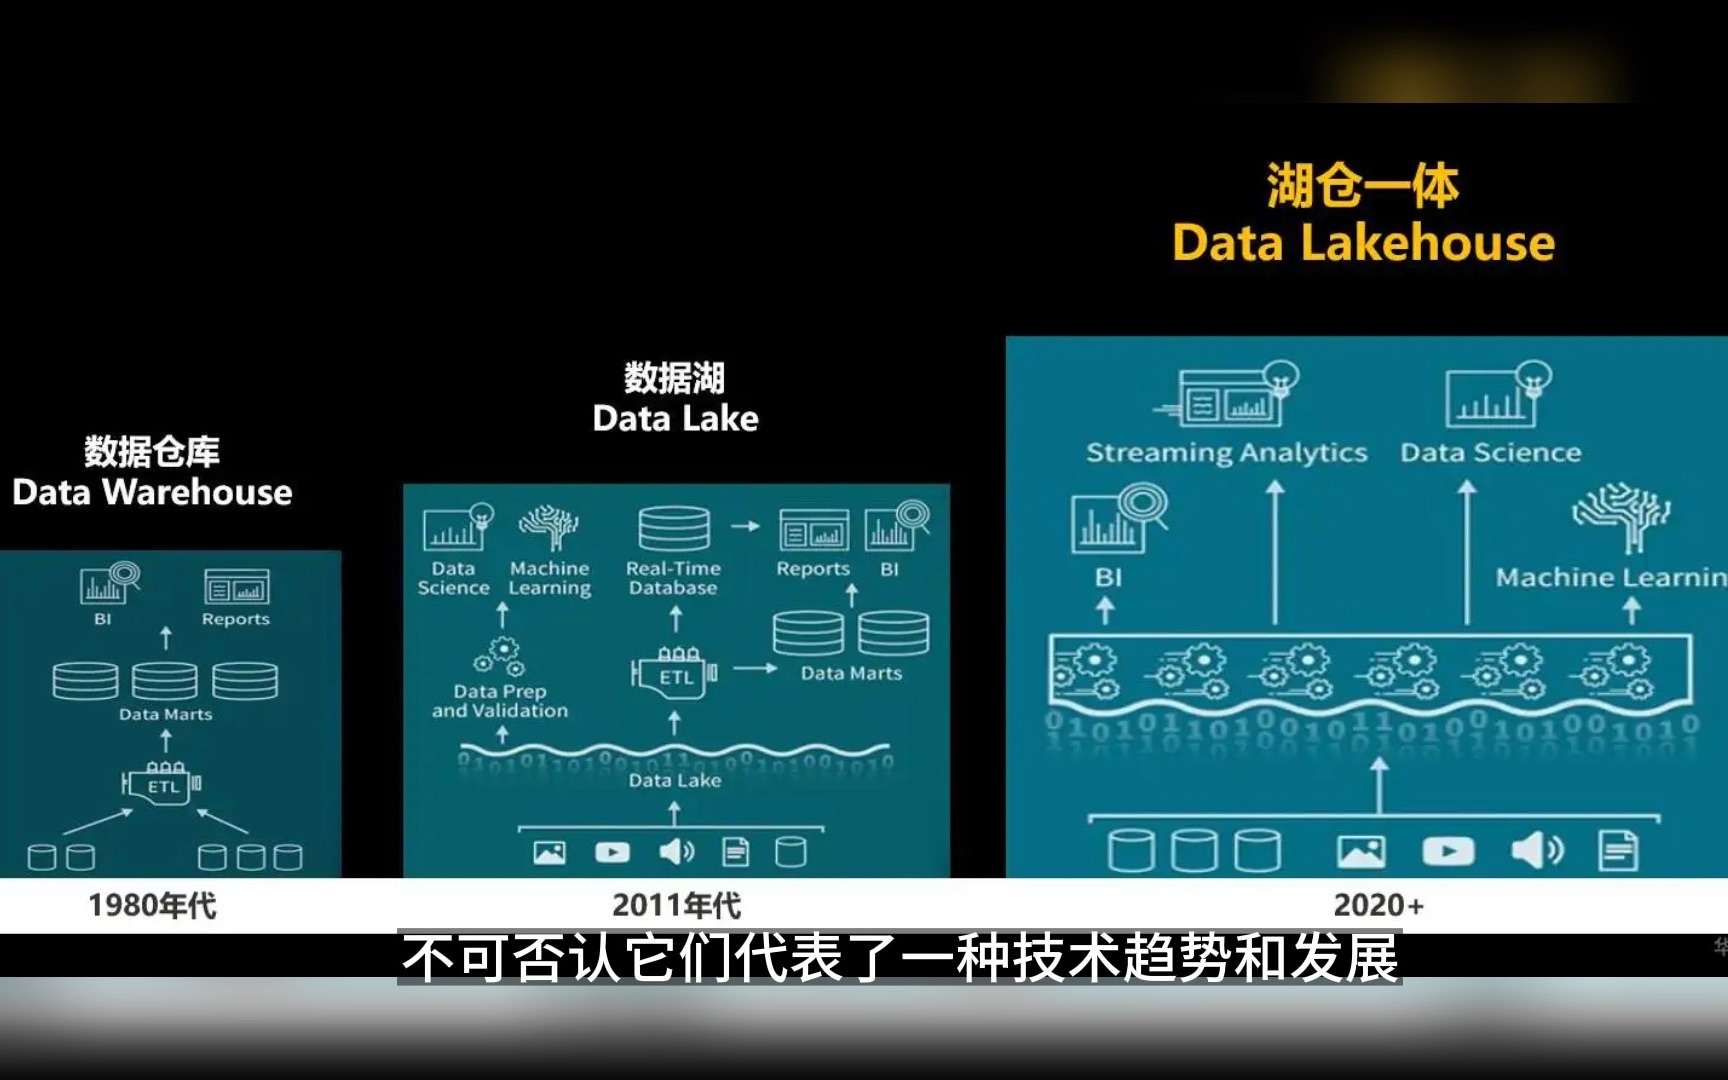
湖仓一体架构的核心优势解析
为什么越来越多的企业选择转向湖仓一体?这并非跟风,而是基于实际业务痛点的理性选择,业内专家指出,这种架构能够显著降低数据管理的复杂度,让数据团队从繁琐的ETL搬运工作中解放出来,专注于数据价值的挖掘。
降低存储与计算成本
传统架构中,为了追求查询速度,往往需要在数据仓库中保留大量冗余数据,或者在数据湖中进行复杂的预处理,湖仓一体利用对象存储(如AWS S3、阿里云OSS)作为底层存储,实现了存储与计算的彻底分离。
- 存储成本低廉:对象存储的价格远低于传统SAN/NAS存储,据行业共识认为,采用对象存储可将长期数据保留成本降低50%以上。
- 弹性扩展:计算资源可以根据查询负载动态伸缩,避免资源闲置浪费。
消除数据孤岛与延迟
在旧有架构中,数据从湖到仓的同步往往需要数小时甚至数天,导致报表数据滞后,湖仓一体通过统一元数据管理,确保数据在写入湖的同时即可被分析引擎直接读取。
- 实时性提升:支持近实时(Near Real-Time)的数据摄入与分析,满足运营监控等场景需求。
- 单一事实来源:所有应用(BI报表、机器学习、数据科学)都访问同一份数据副本,消除了因数据不一致导致的决策偏差。
如何构建湖仓一体数据仓库实操指南
构建湖仓一体并非简单的软件安装,而是一套系统工程,从技术选型到落地实施,需要遵循严谨的步骤,以下结合主流开源生态与商业解决方案,梳理出关键路径。
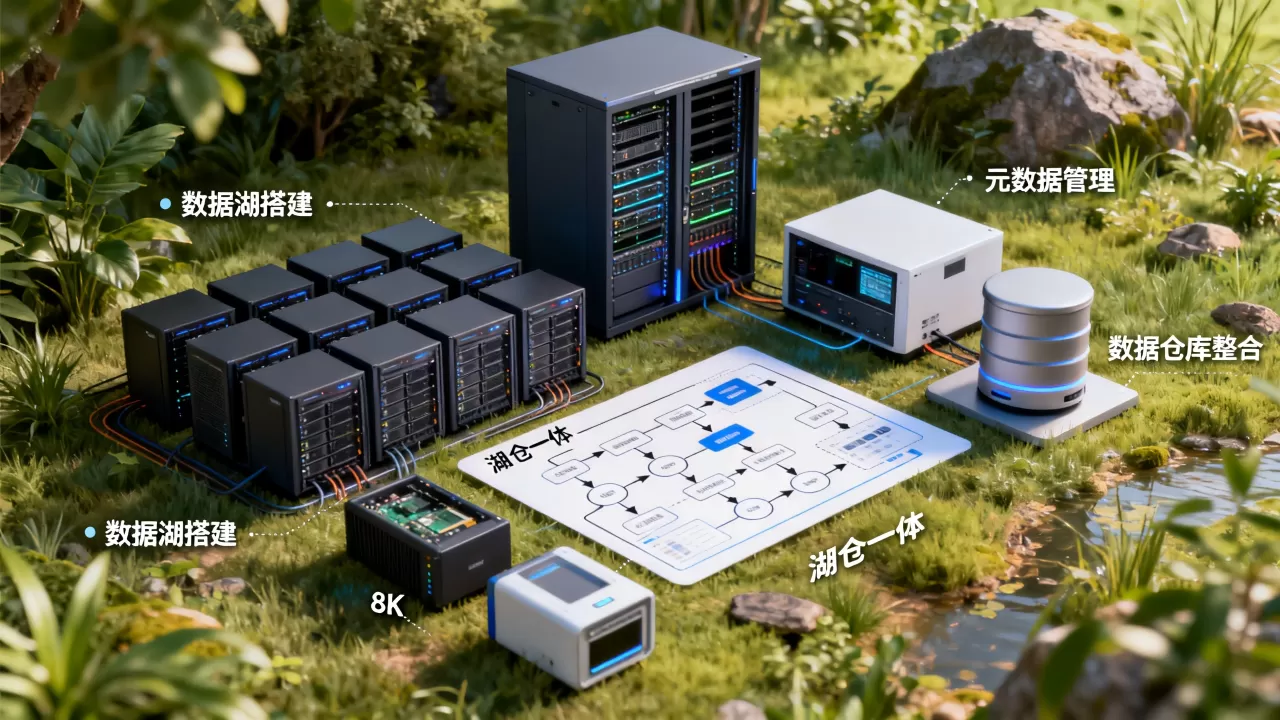
技术选型:Open Table Formats是关键
湖仓一体的基石是开放表格格式(Open Table Formats),这些格式解决了数据湖文件难以被多种引擎共享的问题,目前主流的选择包括Apache Iceberg、Apache Hudi和Apache Delta Lake。
- Apache Iceberg:由Netflix发起,现由Apache基金会托管,其优势在于强大的元数据管理能力和对多种计算引擎(Spark, Flink, Trino)的良好支持,适合大规模离线和实时混合负载。
- Apache Hudi:由Uber开源,擅长处理增量数据更新和删除,特别适合CDC(变更数据捕获)场景,但在复杂查询性能上略逊于Iceberg。
- Delta Lake:由Databricks主导,与Spark生态结合紧密,上手简单,但在非Spark引擎的支持上相对较弱。
建议根据团队技术栈选择:若团队熟悉Spark,Delta Lake是快速入门之选;若追求跨引擎兼容性和大规模扩展,Iceberg更为稳妥。
实施步骤:从0到1的搭建流程
构建过程可分为四个阶段,每个阶段都需严格控制质量。
第一阶段:基础设施准备
部署对象存储作为数据湖底层,配置权限策略,确保只有授权服务账户才能访问敏感数据,部署统一的元数据服务(如Hive Metastore或AWS Glue Catalog),这是连接存储与计算引擎的桥梁。
第二阶段:数据接入与标准化
使用流式处理框架(如Kafka + Flink)或批量处理框架(如Spark)将数据写入目标表,在此阶段,必须定义清晰的Schema(模式),并启用ACID事务支持。
# 示例:使用Spark SQL创建Iceberg表
CREATE TABLE my_database.my_table (
    id INT,
    name STRING,
    event_time TIMESTAMP
) USING iceberg
PARTITIONED BY (event_time);
第三阶段:查询引擎配置
部署分析引擎(如Trino或Presto),并配置其与元数据服务的连接,确保查询引擎能够识别并优化Iceberg/Hudi/Delta格式的表,对于高并发查询场景,建议引入缓存层(如Alluxio)以提升读取性能。
第四阶段:数据治理与安全
实施行级和列级权限控制,利用元数据服务中的审计日志,追踪数据访问行为,建立数据质量监控规则,自动检测数据漂移或缺失。
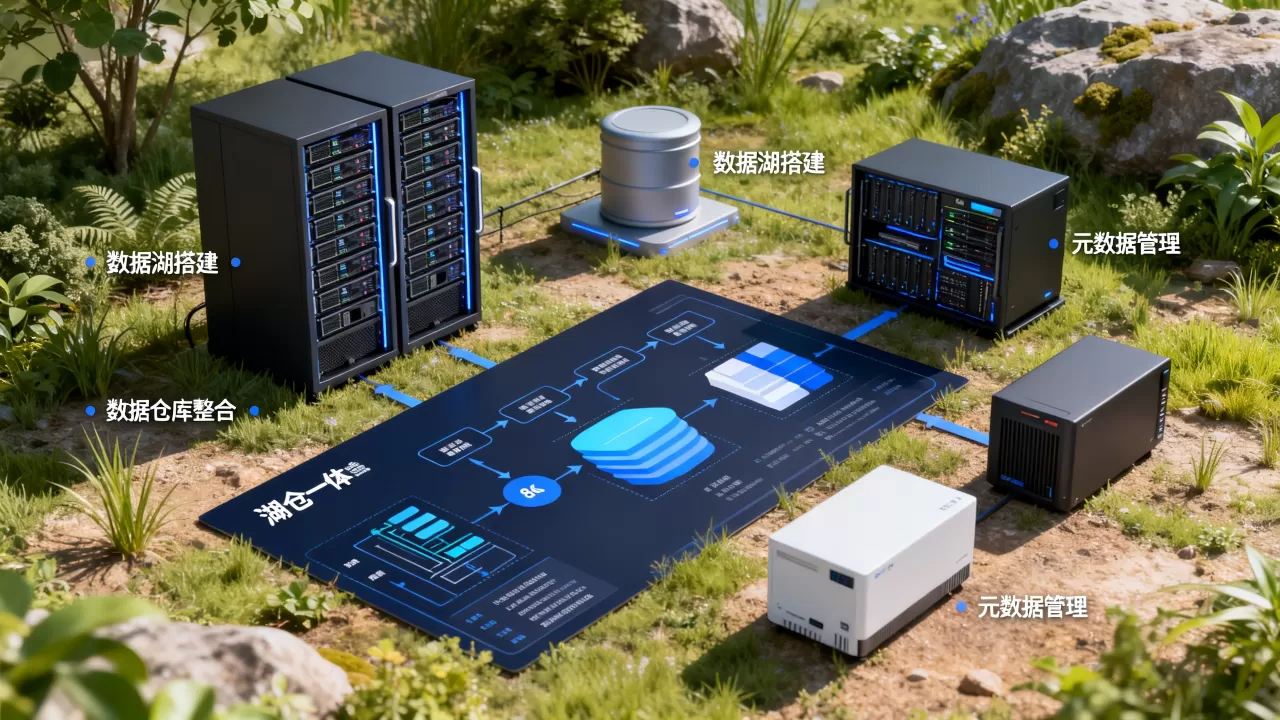
湖仓一体与传统数仓的对比分析
为了更直观地理解湖仓一体的价值,我们将传统数据仓库、数据湖以及湖仓一体进行对比。
| 特性 | 传统数据仓库 (DW) | 数据湖 (Data Lake) | 湖仓一体 (Lakehouse) |
|---|---|---|---|
| 数据类型 | 结构化为主 | 结构化、半结构化、非结构化 | 全类型统一支持 |
| 存储成本 | 高 | 低 | 低 |
| 查询性能 | 极高(优化良好) | 较低(需预处理) | 高(通过索引和裁剪优化) |
| 数据一致性 | ACID强一致 | 最终一致或弱一致 | ACID强一致 |
| 适用场景 | 核心BI报表 | 数据探索、机器学习原始数据 | 实时分析、AI训练、综合报表 |
从表中可以看出,湖仓一体并非要完全取代传统数仓,而是填补了数据湖在事务支持和查询性能上的短板,对于大多数企业而言,湖仓一体是构建下一代数据平台的最优解。
常见误区与避坑指南
尽管湖仓一体优势明显,但在落地过程中,许多企业容易陷入误区。
认为引入湖仓一体就能自动解决数据质量问题
技术架构只是载体,数据质量取决于治理流程,如果源头数据混乱,湖仓一体只会让脏数据跑得更快,必须在数据接入层建立严格的质量校验机制。
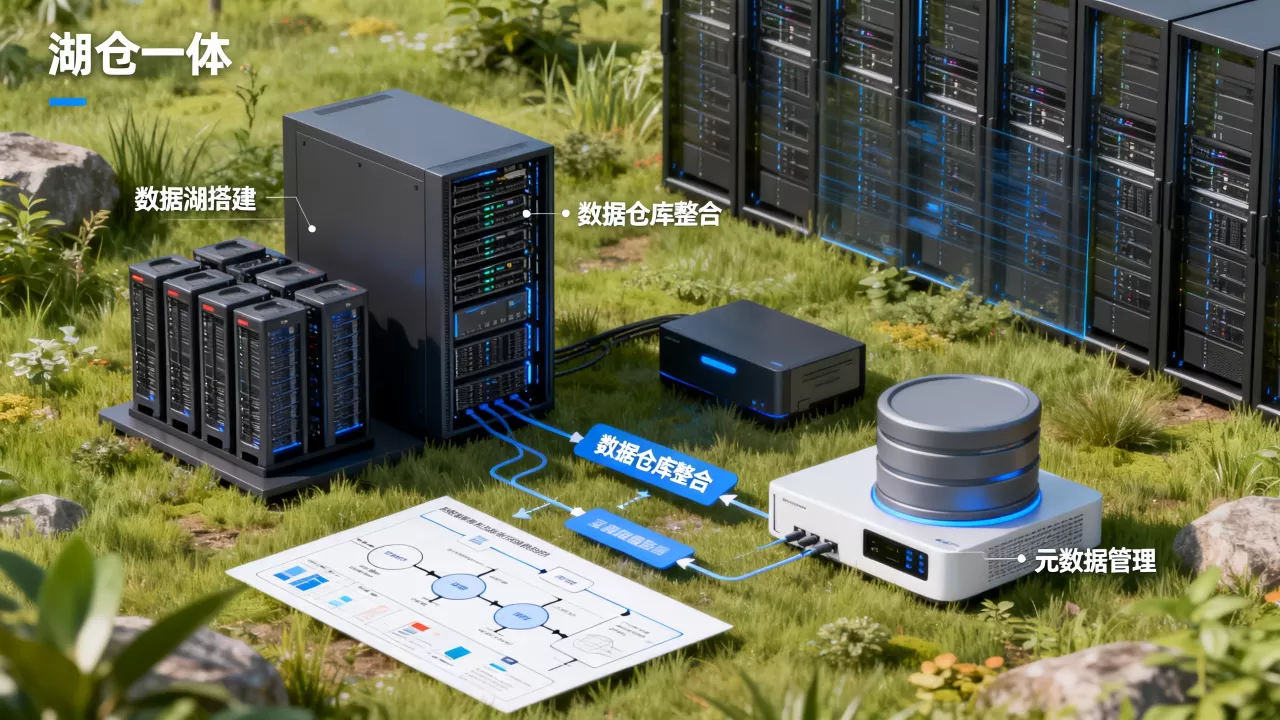
忽视小文件问题
在数据湖中,频繁的小文件写入会导致元数据膨胀,严重影响查询性能,务必配置自动合并(Compaction)策略,定期将小文件合并为大文件,以维持高性能。
过度追求新技术栈
不要为了使用Iceberg而强行替换现有的Spark作业,应评估迁移成本与收益,采用渐进式迁移策略,先在非核心业务中试点,验证效果后再全面推广。
湖仓一体的演进方向
随着AI大模型的兴起,湖仓一体正在向“AI原生”方向演进,未来的湖仓系统将更好地支持向量数据存储与检索,直接服务于大模型的训练与推理,Serverless架构的普及将进一步降低使用门槛,让数据湖仓像水电一样即开即用。
据工信部数据,近年来国内企业在数据基础设施上的投入持续增长,其中对云原生数据架构的关注度显著提升,这表明,湖仓一体不仅是技术趋势,更是产业共识。
构建湖仓一体数据仓库常见问题解答
构建湖仓一体数据仓库需要多少预算?
湖仓一体的成本结构与传统数仓不同,主要支出在于对象存储费用、计算资源费用以及运维人力,初期投入相对较低,因为无需购买昂贵的硬件设备,随着数据量增长,存储成本线性增加,但计算成本可通过弹性伸缩优化,具体价格取决于数据规模、查询频率及所选云服务提供商,建议先进行小规模POC(概念验证)以估算实际成本。
湖仓一体是否支持实时数据处理?
是的,现代湖仓一体架构通过结合流式计算引擎(如Flink)和支持增量更新的表格格式(如Hudi或Iceberg),能够支持毫秒级至秒级的数据延迟,这使得实时大屏监控、实时风控等场景成为可能,打破了传统数仓只能处理T+1数据的局限。
湖仓一体数据仓库在金融行业的落地案例有哪些?
在金融行业,湖仓一体被广泛应用于反欺诈、实时风控和客户画像构建,某大型银行通过引入湖仓一体架构,将交易数据的处理延迟从小时级降低到分钟级,显著提升了欺诈检测的及时性,这种架构使得金融机构能够在保证数据安全合规的前提下,充分利用海量交易数据进行深度分析。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/205283.html