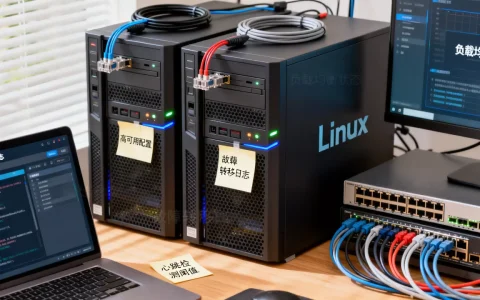
构建高可用Linux服务器的核心在于通过冗余架构消除单点故障,并结合自动化监控与快速恢复机制,确保业务在硬件失效或网络波动时仍能保持连续运行。
在2026年的数字化环境中,企业对于系统稳定性的要求已不再局限于“不宕机”,而是追求极致的无缝切换能力,许多运维团队在初期往往忽视架构设计的冗余性,直到遭遇突发流量或硬件故障才追悔莫及,构建一个真正高可用的Linux环境,需要从底层硬件选型、操作系统配置、网络拓扑到应用层部署进行全方位的系统性规划,这不仅仅是安装几个软件包那么简单,而是一套严密的工程体系。

高可用架构的核心组件与选型策略
高可用(High Availability, HA)的实现依赖于消除系统中的单点故障,这意味着任何单一组件的失效都不应导致整个服务的中断,业内专家指出,合理的组件选型是构建高可用架构的基石,错误的选型会让后续所有的配置努力付诸东流。
负载均衡器的部署逻辑
负载均衡器是流量进入系统的入口,也是第一个需要实现冗余的环节,常见的方案包括硬件负载均衡器(如F5)和软件负载均衡器(如Nginx、HAProxy),对于大多数中小型企业而言,基于Linux的软件负载均衡方案更具性价比。
- 主备模式(Active-Standby):适用于对实时性要求不高、成本敏感的场景,一台主节点处理流量,另一台备用节点实时同步状态,主节点故障时备用节点接管。
- 主主模式(Active-Active):两台或多台节点同时处理流量,通过Keepalived等工具管理虚拟IP(VIP),这种方式能充分利用硬件资源,提升整体吞吐量。
存储系统的冗余机制
数据是企业的生命线,存储层的高可用直接关系到数据的安全性,传统的RAID技术虽然能提供一定的磁盘容错能力,但在面对控制器故障或大规模数据损坏时显得力不从心。
- 分布式存储:如Ceph或GlusterFS,通过将数据分片并复制到多个节点,实现存储层的横向扩展和高可用。
- SAN/NAS集群:在企业级环境中,双控制器SAN存储配合多路径I/O(MPIO)技术,是保证存储高可用的主流选择。
网络拓扑的冗余设计
网络连通性是服务可用的前提,物理链路的冗余至关重要,建议采用双上行链路连接至不同的核心交换机,并配置链路聚合(LACP)或生成树协议(STP)的优化版本,以防止环路并实现链路故障自动切换。
操作系统层面的高可用配置实战
选定好硬件和基础软件后,Linux操作系统本身的配置决定了系统的健壮性,许多运维人员容易忽略内核参数的优化,导致系统在高压下表现不佳。
内核参数调优指南
Linux内核默认参数通常偏向通用场景,针对高可用服务器需要进行针对性调整,调整TCP连接队列长度、文件描述符限制以及内存回收策略。
- 修改sysctl.conf:增加
net.core.somaxconn和net.ipv4.tcp_max_syn_backlog的值,以应对突发的大规模连接请求。 - 调整文件句柄限制:通过
ulimit -n或修改/etc/security/limits.conf,确保进程能打开足够的文件描述符,避免“Too many open files”错误。 - 启用内核panic自动重启:配置
kernel.panic参数,当系统发生严重错误时自动重启,缩短故障恢复时间。
服务监控与告警体系
没有监控的高可用是盲目的,传统的Zabbix或Prometheus是标配,但2026年的趋势更倾向于轻量级、云原生的监控方案。
- 指标采集:不仅监控CPU、内存,更要关注应用层的响应时间、错误率和吞吐量。
- 日志聚合:使用ELK(Elasticsearch, Logstash, Kibana)或Loki栈,集中收集和分析日志,快速定位故障根源。
- 智能告警:设置分级告警策略,避免告警疲劳,关键故障应通过电话或短信即时通知,一般警告可通过邮件或IM工具发送。
常见高可用方案对比与选型建议
在实际项目中,选择哪种高可用方案往往取决于业务场景和技术栈,不同的方案在成本、复杂度和性能上存在显著差异。
| 方案名称 | 适用场景 | 优点 | 缺点 |
典型组件 |
|---|---|---|---|---|
| Keepalived + Nginx | Web服务入口 | 配置简单,社区支持好,成本低 | 仅支持HTTP/HTTPS,需配合脚本实现健康检查 | Keepalived, Nginx |
| Pacemaker + Corosync | 数据库、中间件 | 资源管理灵活,支持复杂依赖关系 | 配置复杂,学习曲线陡峭 | Pacemaker, Corosync, CRM |
| Keepalived + LVS | 高并发TCP服务 | 性能极高,内核级转发 | 配置难度大,对运维人员要求高 | Keepalived, LVS |
| Kubernetes | 微服务架构 | 自动故障转移,弹性伸缩能力强 | 架构复杂,资源消耗大,运维门槛高 | K8s, etcd, CNI |
数据库高可用方案解析
数据库通常是整个架构中最难实现高可用的部分,MySQL和PostgreSQL等关系型数据库各有其成熟的高可用方案。
- MySQL MHA/Orchestrator:通过监控主从复制状态,在主节点故障时自动提升从节点为主节点,这种方式对应用透明,但存在数据丢失的风险(取决于binlog同步情况)。
- MySQL Group Replication (MGR):基于Paxos协议的多主集群,提供强一致性保证,但写性能受限于最慢节点。
- PostgreSQL Patroni:结合etcd或Consul进行Leader选举,支持多种后端存储,是目前PostgreSQL高可用的主流选择。
故障演练与持续改进机制
构建高可用系统不是一次性的工作,而是一个持续迭代的过程,许多团队在系统上线后便停止了优化,导致架构逐渐老化,无法应对新的业务挑战。
混沌工程实践
混沌工程(Chaos Engineering)通过在系统中注入故障(如杀死进程、模拟网络延迟、断开磁盘连接),验证系统的容错能力,Netflix的Chaos Monkey是这一领域的先驱,国内也有类似开源工具如ChaosBlade。
- 制定实验计划:明确实验目标,确定影响范围,制定回滚方案。
- 执行故障注入:在生产环境或预发环境中模拟真实故障。
- 观察与评估:监控系统指标和日志,评估系统是否按预期恢复,是否存在未发现的漏洞。
文档与知识库建设
故障处理经验是团队的宝贵资产,建立完善的运维文档和故障知识库,记录每次故障的现象、原因、处理过程和复盘总结,这不仅有助于新成员快速上手,也能在类似故障再次发生时提供快速参考。
Q&A: 构建高可用linux服务器pdf相关常见问题
构建高可用linux服务器pdf中提到的Keepalived主备切换时间是多少?
Keepalived的主备切换时间通常在秒级,具体取决于VRRP通告间隔(advert_int)和超时时间(nopreempt)的配置,默认情况下,切换时间约为3-5秒,对于金融或实时交易等对延迟极度敏感的场景,可以通过调整内核参数和优化网络环境将切换时间压缩至毫秒级,但需权衡CPU开销和网络稳定性。
高可用Linux服务器配置中,如何确保数据一致性?
数据一致性主要依赖于数据库层面的同步机制和应用层的事务管理,在MySQL中,半同步复制(Semi-Sync Replication)可以确保至少一个从节点接收并写入日志后才返回成功,从而降低主节点故障时的数据丢失风险,在应用层,采用分布式事务框架(如Seata)或最终一致性方案(如消息队列+本地消息表)来处理跨服务的数据同步问题。
中小企业选择高可用方案时,成本与性能的平衡点在哪里?
对于中小企业,建议优先采用软件定义的高可用方案,如Keepalived+Nginx或Pacemaker+Corosync,避免高昂的硬件负载均衡器投入,性能方面,通过合理的硬件配置(如SSD存储、多核CPU)和内核参数调优,通常能满足90%以上的业务需求,只有在流量极大或对可用性要求极高(如99.99%以上)时,才考虑引入Kubernetes或分布式存储等复杂架构。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/205148.html