大语言模型微调方式有哪些?揭秘微调的真相

大语言模型微调并非解决所有业务痛点的“万能药”,盲目微调往往会导致基座模型能力退化、算力资源浪费以及过拟合风险。核心结论是:在绝大多数垂直业务场景下,检索增强生成(RAG)与提示词工程的优先级远高于微调;微调的真正价值在于注入行业知识范式、统一输出格式规范以及优化模型交互风格,而非单纯的知识灌输。企业应遵循“先提示,后检索,再微调”的实施路径,避免陷入技术自嗨的陷阱。

关于大语言模型微调方式

认清现实:微调解决的是“形式”而非“存储”问题

很多技术团队误以为微调就是把企业文档“喂”给模型,让它记住所有细节,这是一个致命的认知误区。大语言模型微调方式的核心逻辑,是调整模型参数以适应特定任务的数据分布,而不是充当外挂硬盘。

  1. 知识存储效率低: 模型参数虽然庞大,但存储知识的密度极低,试图通过微调让模型记住大量事实性数据,不仅成本高昂,且一旦数据更新,必须重新训练,维护成本极高。
  2. 幻觉问题难根除: 微调后的模型更容易产生“幻觉”,尤其是当训练数据质量不高时,模型会一本正经地胡说八道。
  3. catastrophic forgetting(灾难性遗忘): 在垂直领域数据上强力微调,极易导致模型丢失基座阶段的通用推理能力,得不偿失。

关于大语言模型微调方式,说点大实话,微调更适合解决“怎么做”的问题,比如让它学会特定的说话语气、固定的JSON输出格式,或者特定的逻辑推理链条。

技术选型:全量微调与PEFT的实战博弈

在具体操作层面,选择合适的微调策略直接决定了投入产出比(ROI),除非你是拥有千亿参数基座模型的大厂,否则全量微调几乎不在考虑范围内。

  1. 全量微调: 理论效果上限最高,但需要极高的算力支撑,且极易破坏预训练知识,对于绝大多数中小企业,这是一条死胡同。
  2. 参数高效微调(PEFT): 这是目前工业界的绝对主流,其中LoRA(Low-Rank Adaptation)技术通过在原模型旁路增加低秩矩阵,实现了仅训练极少量参数即可达到接近全量微调的效果。
    • 显存占用大幅降低,单张消费级显卡即可运行。
    • 训练速度快,迭代周期短,适合敏捷开发。
    • 插件化特性,一个基座模型可挂载多个不同任务的LoRA权重,灵活部署。

实战建议:优先选择LoRA及其变体(如QLoRA),在保证模型底座能力不崩塌的前提下,以最小成本实现领域适配。

数据质量:决定微调成败的“隐形杀手”

关于大语言模型微调方式

算法工程师往往沉迷于调参,却忽视了数据清洗。微调界有一条铁律:垃圾进,垃圾出。 高质量的1000条指令数据,效果往往吊打低质量的10万条数据。

  1. 数据多样性: 训练数据不能只覆盖单一场景,必须涵盖用户可能提问的各种变体,防止模型过拟合单一模式。
  2. 数据准确性: 错误的标注会通过梯度下降放大模型的错误认知,人工审核与多轮清洗是必不可少的环节。
  3. 指令设计: Instruction的构建需要极强的技巧,指令必须清晰、无歧义,且要包含思维链引导,让模型学会推理过程而非死记硬背答案。

避坑指南:RAG与微调的协同作战策略

在构建企业级AI应用时,不要在微调和RAG之间做单选题,这是一道多选题。

  1. 第一阶段:提示词工程。 90%的初步需求都能通过优化Prompt解决,这一阶段成本最低,迭代最快。
  2. 第二阶段:检索增强生成(RAG)。 当需要引入大量实时更新的私有知识时,搭建向量数据库,通过检索相关片段辅助模型生成,这解决了知识时效性和准确性问题。
  3. 第三阶段:监督微调(SFT)。 当RAG检索到的内容模型无法很好地利用,或者需要模型输出极其规范的格式(如医疗病历结构化、代码生成)时,才引入微调。

微调的作用是让模型学会如何更好地利用检索到的知识,或者学会行业内的“黑话”和思维模式。 这种“RAG+SFT”的组合拳,才是目前最落地的技术架构。

评估体系:拒绝主观臆断

微调完成后,如何评估效果?不能只靠“感觉不错”,必须建立量化的评估体系。

  1. 客观指标: 针对分类、实体抽取等任务,使用准确率、召回率、F1值进行硬性考核。
  2. 主观指标: 针对生成式任务,利用GPT-4等更强模型进行打分,或引入人工评估团队,从流畅性、相关性、准确性三个维度打分。
  3. 对比测试: 必须与基座模型进行A/B Test,确保微调后的模型在特定任务上确实有提升,且在通用任务上没有明显退化。

相关问答

关于大语言模型微调方式

微调后的模型效果不如原模型,是什么原因?

这种情况通常由两个原因导致:一是训练数据质量过差,包含大量噪声或错误标注,污染了模型参数;二是训练超参数设置不当,如学习率过高导致模型原有知识被破坏,或训练轮数过多导致过拟合,建议降低学习率,减少训练轮数,并严格清洗数据,采用LoRA等参数高效微调方式来冻结原模型主体参数。

企业私有数据量不大,只有几百条,适合做微调吗?

适合,但前提是这几百条数据必须是经过精心打磨的“黄金数据”,对于特定风格的模仿或特定格式的输出,几百条高质量指令数据足以产生显著效果,此时建议使用Few-shot Learning或小样本微调,配合RAG技术补充知识库,能够以极低成本获得优秀的业务效果,切勿为了追求数据量而强行灌入低质量数据。

如果你在微调实战中遇到过“模型变傻”或“过拟合”的坑,欢迎在评论区分享你的解决方案。

首发原创文章,作者:王坚‌,如若转载,请注明出处:https://test.idctop.com/article/152686.html

赞 (0)
java开发oa难吗?java开发oa系统流程详解
上一篇 2026年4月4日 03:39
apache域名重定向怎么设置,apache重定向请求配置教程
下一篇 2026年4月4日 03:39

相关推荐

  • 大模型用哪种卡比较好?大模型训练用什么显卡性价比高

    在大模型训练与推理的硬件选型中,不存在绝对的“万能神卡”,最优解永远是“算力性能、显存带宽、互联能力与综合成本”的动态平衡,对于大多数企业与开发者而言,NVIDIA H100/A100依然是不可撼动的生产力首选,而国产算力卡(如华为昇腾、海光DCU等)则在推理侧与特定信创场景下具备极高的替代价值与成本优势,盲目……

    2026年4月6日
    9600
  • 阿里云CDN报503错误怎么办?503服务不可用怎么解决

    阿里云CDN出现503错误,本质是源站服务器无法响应或负载过高,解决核心在于排查源站状态、检查回源配置及优化缓存策略,而非单纯重启CDN节点,当你的网站前端突然弹出“503 Service Unavailable”时,焦虑感往往比错误本身更令人窒息,这不仅仅是代码报错,更是业务流量的断崖式下跌,在阿里云生态中……

    2026年6月2日
    4200
  • 摄像头云存储空间不足怎么办?清理扩容省钱妙招!

    国内摄像头云存储空间不足怎么办? 核心解决方案在于优化存储设置、清理无效数据、考虑扩容或替代方案,以下是具体、可操作的应对策略: 优先排查与优化:低成本高效释放空间精准调整录像设置:降低分辨率与帧率: 这是最直接有效的方式,将分辨率从2K/4K降至1080P甚至720P,帧率从30fps降至15fps,能显著减……

    2026年2月9日
    18400
  • yii上传图片到cdn报错怎么办,yii上传图片到cdn

    在Yii框架中上传图片至CDN,核心方案是通过自定义FileValidator或重写UploadBehavior,将文件流直接推送至阿里云OSS、腾讯云COS或七牛云等对象存储服务,并替换数据库中的本地路径为CDN域名链接,从而实现静态资源分离与全球加速,传统本地存储模式在2026年已难以满足高并发场景下的性能……

    2026年5月12日
    7700
  • 迅雷cdn技术是什么原理,迅雷cdn技术怎么加速

    迅雷CDN技术通过“P2P+CDN”混合架构与边缘智能调度,在2026年实现了带宽成本降低40%以上且首屏加载速度提升30%的显著效果,是解决高并发场景下流量瓶颈的最优解,技术底层逻辑:从传统CDN到混合加速的演进传统CDN依赖中心节点分发,随着4K/8K视频及云游戏普及,带宽成本呈指数级增长,迅雷利用其多年积……

    2026年5月31日
    3500
  • 服务器定价是多少?云服务器一年费用多少钱

    2026年服务器定价已彻底告别“一刀切”模式,核心受芯片算力迭代、绿电成本及AIGC算力潮汐需求三重驱动,企业需基于“TCO全局拥有成本”与业务场景精准匹配,方能锁定最优性价比,2026服务器定价底层逻辑与市场全景算力重构定价坐标系根据IDC 2026年第一季度数据显示,全球AI服务器出货量占比已突破42%,传……

    2026年4月23日
    8000
  • 美国ai大模型博士就业前景如何?2026年薪资待遇高吗

    2026年将是美国AI大模型领域博士人才供需关系发生根本性转折的关键节点,核心结论非常明确:单纯具备算法理论深度的学术型博士将面临严峻的就业瓶颈,而具备“垂直领域知识+工程化落地能力+产品思维”的复合型博士将成为市场争抢的稀缺资源,对于计划攻读或正在攻读该学位的群体而言,提前布局应用层技术与跨学科能力,是应对未……

    2026年3月29日
    10100
  • fdisk磁盘扩容如何操作才正确,注意事项有哪些?

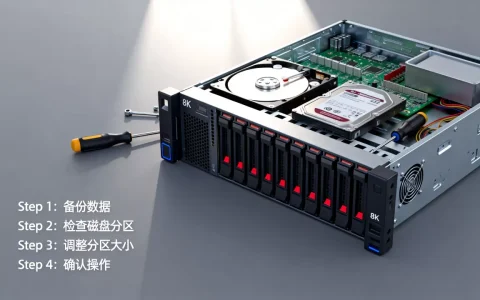
    使用fdisk进行磁盘扩容,核心方法是删除原有分区并重建一个更大分区,再通过resize2fs等工具扩展文件系统,全程需严谨操作并提前备份数据,很多运维人员习惯用fdisk处理分区任务,但扩容时容易忽略起始扇区对齐或文件系统扩展步骤,下面从实际场景出发,拆解fdisk扩容的完整流程、常见坑位以及工具对比,帮你一……

    2026年7月22日
    1800
  • 大模型刷爆题库到底怎么样?大模型刷题库真的有用吗

    大模型刷题并非“作弊神器”,而是一把双刃剑,其核心价值在于极高效率的知识点检索与思路启发,而非直接替代人类的思考与考试能力,真实体验表明,对于客观选择题和定义类题目,大模型准确率惊人,能实现“降维打击”;但在涉及复杂逻辑推理、主观论述以及最新时效性强的题目时,大模型常常会出现“一本正经胡说八道”的幻觉现象,正确……

    2026年3月9日
    13900
  • 主流ai大模型产品研发测评,这些差距确实大,哪款AI大模型最值得用?

    当前主流AI大模型产品研发测评结果显示,不同厂商之间的技术差距正在拉大,这种差距不仅体现在基础能力上,更反映在应用落地效率与商业化成熟度层面,头部模型已形成明显技术壁垒,中尾部产品在核心指标上存在代际差,核心能力断层:头部模型建立多维优势逻辑推理与复杂任务处理头部模型在数学推导、代码生成及多步逻辑推理任务中表现……

    2026年3月9日
    21000

发表回复

您的邮箱地址不会被公开。 必填项已用 * 标注