

运维效率与系统稳定的核心引擎
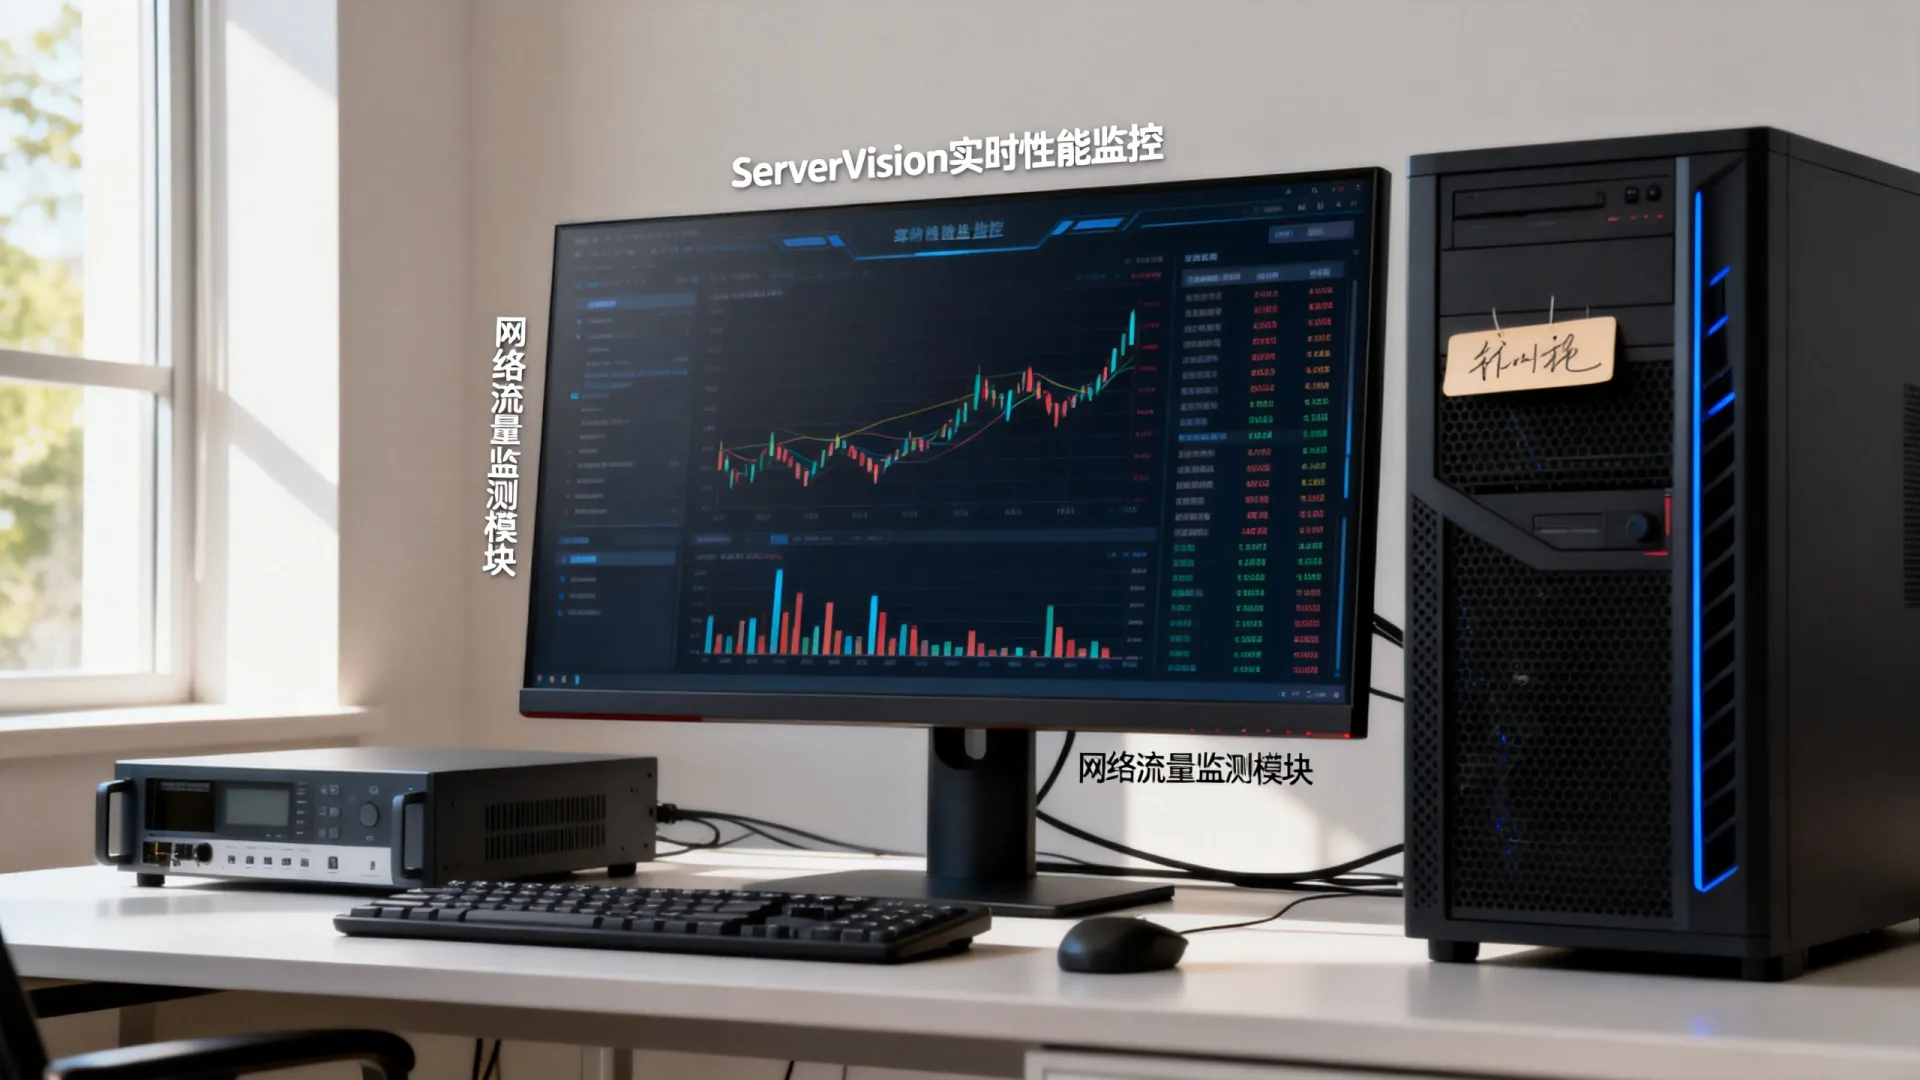
服务器监控可视化工具是现代IT运维不可或缺的中枢神经系统,它通过直观的图形界面,将服务器集群复杂的运行状态(CPU、内存、磁盘、网络、进程、服务健康度等)实时呈现,使运维人员能够迅速洞察系统瓶颈、预测潜在风险,并在故障发生时精准定位根因,从而显著提升系统稳定性、资源利用率和运维响应效率。
核心价值:从数据洪流到运维智能
- 全局态势感知: 告别命令行和分散日志,通过统一仪表盘一目了然掌握整个服务器集群或数据中心的实时运行状态与历史趋势。
- 异常实时告警: 基于预设阈值或智能基线,在CPU飙升、内存耗尽、磁盘空间告急、服务宕机等异常发生时,通过邮件、短信、钉钉、企业微信等渠道秒级推送告警,抢占故障处理黄金时间。
- 性能瓶颈定位: 深入钻取性能指标关联性,快速定位是应用代码效率低下、数据库查询缓慢,还是底层资源(如IOPS、网络带宽)不足导致的系统卡顿。
- 容量规划支撑: 分析历史资源消耗趋势(如CPU日均峰值、存储月增长率),为服务器扩容、云资源采购或架构优化提供精准数据支撑,避免资源浪费或突发性容量不足。
- 故障回溯与根因分析: 结合详细的历史性能快照与日志事件时间线,在故障发生后快速回溯时间节点,关联分析多维度指标,精准定位故障根源(如某个部署引发的内存泄漏)。
- 运维报告自动化: 自动生成系统可用性报告、资源利用率报告、SLA合规性报告,满足运维审计和向上汇报需求,节省大量人工整理时间。
核心功能剖析:构建高效监控体系
-
全面灵活的数据采集:
- 支持广泛协议/接口: SNMP(网络设备)、WMI(Windows)、SSH(Linux/Unix)、JMX(Java应用)、API(云平台、数据库、自定义应用)、Prometheus exporters、StatsD等。
- 无代理与有代理结合: 轻量级Agent部署采集主机级细粒度指标,无代理方式通过API拉取云服务或特定应用数据。
- 自定义指标采集: 通过脚本或插件,灵活收集业务关键KPI(如订单处理速率、队列积压数)。
-
强大的数据处理与存储:
- 时序数据库引擎: 核心采用高性能时序数据库(如InfluxDB、TimescaleDB、VictoriaMetrics),高效存储和检索海量时间序列指标数据。
- 数据聚合与降采样: 对原始数据进行实时聚合(如计算1分钟平均CPU使用率)、长期存储降采样(保留日/周/月级别的聚合数据),平衡查询速度与存储成本。
- 数据清洗与丰富: 过滤无效数据点、填充缺失值(可选策略)、为数据附加标签(如环境、业务组、负责人),提升数据质量和可分析性。
-
直观、灵活、强大的可视化:
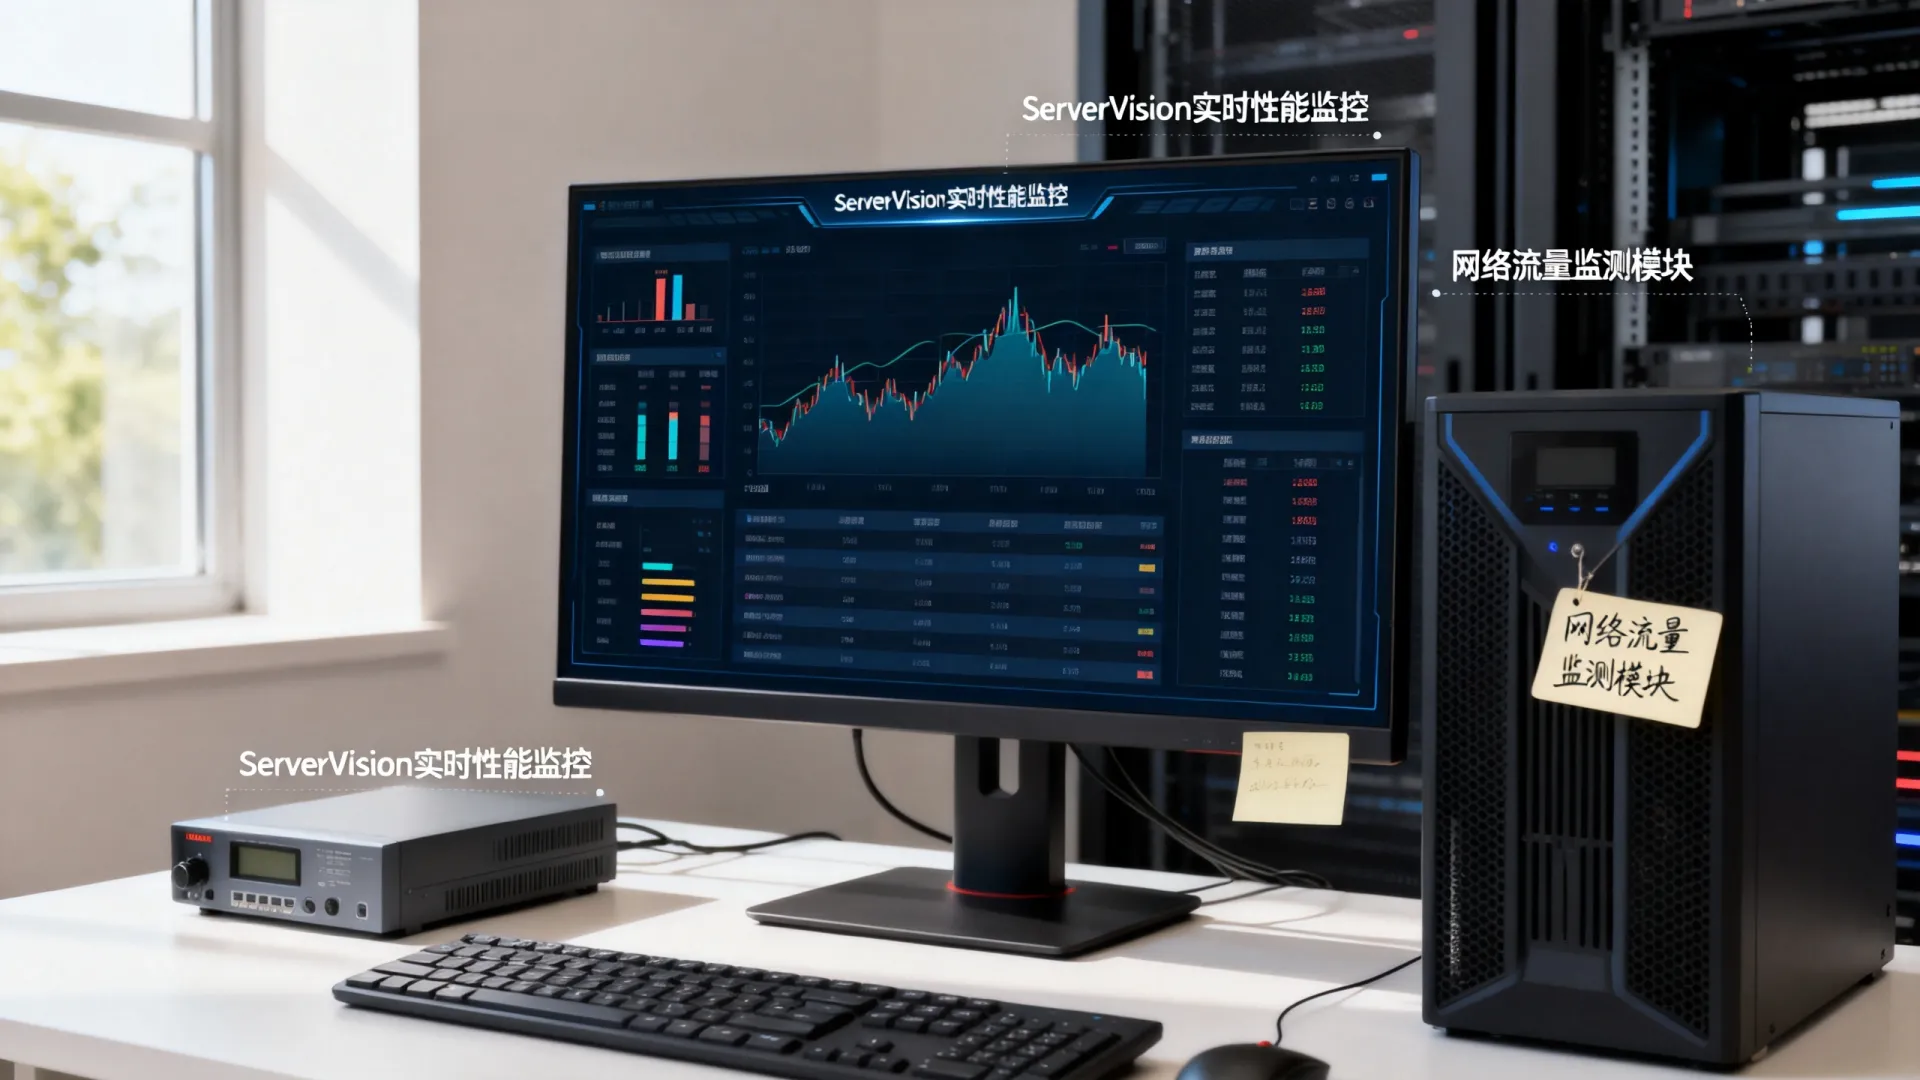
- 丰富图表类型: 折线图(趋势分析)、柱状图/条形图(对比)、仪表盘(实时状态)、饼图/环形图(占比)、热力图(关联分析)、拓扑图(网络/应用依赖关系)、日志事件流等。
- 可定制仪表盘: 用户自由拖拽组件、自定义布局,创建面向不同角色(运维、开发、管理层)和场景(基础监控、应用监控、业务监控)的专属视图。
- 动态交互与下钻: 点击图表联动查看关联指标,下钻到更细粒度(如从集群到主机再到容器/进程),支持时间范围灵活缩放。
- 注释与标记: 在图表上标记关键事件(如部署、变更、故障时间点),便于关联分析影响。
-
智能告警与事件管理:
- 多维度告警规则: 支持基于单一指标阈值、多指标组合逻辑(如CPU高且负载高)、指标变化率、异常检测(AI/ML算法)、无数据上报等进行告警配置。
- 告警分级与收敛: 设置不同严重等级(Warning, Critical),并应用告警抑制、分组、降噪策略(如短时间内同一主机多个告警合并),避免告警风暴淹没关键信息。
- 多渠道通知: 集成邮件、短信、电话、主流IM(钉钉/企业微信/Slack)、Webhook(对接ITSM如Jira Service Desk、Zabbix、PagerDuty)。
- 告警闭环跟踪: 记录告警触发、通知、确认、处理、解决的全过程,便于追溯和分析告警有效性。
-
高级分析与洞察:
- 趋势预测: 基于历史数据,运用统计或机器学习模型预测未来资源使用趋势(如磁盘将在7天后写满),支持主动运维。
- 关联分析: 自动或手动分析不同指标间的相关性(如应用响应时间变慢是否与数据库查询延迟增加同步发生),辅助定位复杂问题。
- 日志与指标联动: 结合日志管理工具(如ELK Stack),在查看异常指标时可快速关联查询对应时间段的错误日志或事件,加速故障排查。
选型关键考量因素
- 监控对象与规模: 物理机、虚拟机、容器(K8s)、云资源、网络设备、数据库、中间件、应用层?监控节点数量级?
- 数据采集能力: 是否支持所需协议和自定义采集?Agent管理是否便捷?
- 可视化灵活性与表现力: 图表是否丰富美观?仪表盘定制是否足够灵活易用?是否支持拓扑等高级视图?
- 告警管理成熟度: 规则配置是否强大灵活?告警收敛降噪机制是否完善?通知渠道是否满足要求?
- 性能与扩展性: 数据采集、存储、查询、渲染在高负载下表现如何?是否支持水平扩展?
- 集成与生态: 能否与现有运维工具链(CMDB、ITSM、自动化平台、日志系统)集成?社区插件或模板是否丰富?
- 部署与维护成本: SaaS云服务还是自建?开源方案(如Grafana+Prometheus+Alertmanager)需要较强技术能力,商业方案(如Datadog, Dynatrace, Zabbix商业版, 阿里云ARMS, 腾讯云CLS)提供开箱即用体验和专业支持。
- 安全性与合规性: 数据传输存储加密、访问控制、审计日志是否符合要求?
主流解决方案概览
- 开源组合(强大灵活,成本可控,需自研能力):
- Prometheus + Grafana + Alertmanager: 云原生监控事实标准,尤其擅长容器(K8s)监控,生态庞大,Grafana可视化能力顶尖。
- Zabbix: 老牌全能选手,内置采集、存储、告警、可视化,功能全面,对传统环境支持好,但界面相对陈旧。
- Nagios Core / Icinga 2: 侧重告警和状态监控,可视化依赖插件(如Grafana),配置相对复杂。
- 商业/云服务(开箱即用,功能全面,服务支持好):
- Datadog: APM+基础设施+日志+用户体验监控一体化,功能强大,SaaS模式便捷,成本较高。
- Dynatrace: AI驱动的全栈可观测性(含应用性能、基础设施、用户体验),自动化程度高,定位问题精准。
- New Relic: 以APM为核心,扩展至基础设施和日志,易用性好。
- 国内云厂商方案: 阿里云ARMS、腾讯云CLS、华为云APM等,深度集成各自云生态,对云上用户友好。
最佳实践与实施建议
- 明确监控目标: 从业务需求出发,定义关键SLO/SLI(如API成功率>99.9%,订单处理延迟<1s),据此确定核心监控指标。
- 分层监控设计:
- 基础设施层: CPU、内存、磁盘、网络、主机存活。
- 服务/中间件层: 数据库连接数/慢查询、消息队列积压、Web服务器状态码/响应时间。
- 应用层: 关键接口性能、JVM指标(GC、线程)、业务自定义指标(订单量、支付成功率)。
- 用户体验层: 前端页面加载时间、操作流畅度(可通过Real User Monitoring工具)。
- 统一监控平台: 尽可能整合分散的监控工具到1-2个核心平台,避免数据孤岛和切换成本。
- 告警策略优化:
- 设置合理阈值: 基于基线而非固定值(如过去7天同一时段平均值的120%)。
- 区分告警级别: 影响核心业务=Critical,潜在风险=Warning。
- 应用告警抑制/分组: 避免重复和风暴。
- 定期评审告警: 关闭无效告警,调整阈值,确保告警 actionable(可行动)。
- 仪表盘设计原则:
- 用户导向: 为不同角色(运维值班、开发、架构师、经理)设计专属视图。
- 信息密度适中: 核心指标突出,避免信息过载。
- 上下文关联: 将关联指标(如应用响应时间与后端DB延迟)放在临近位置。
- 与自动化联动: 将监控事件作为自动化运维(如故障自愈、弹性伸缩)的触发器(当CPU持续>85%时自动扩容)。
- 持续迭代: 监控需求随业务和技术架构变化,定期审视和调整监控策略、指标、仪表盘和告警规则。
未来趋势
- AIOps深度融入: 利用AI/ML进行异常检测(无需阈值)、根因分析自动化、告警智能降噪、预测性维护。
- 可观测性(Observability)演进: 超越传统监控(Metrics),深度融合指标(Metrics)、日志(Logs)、追踪(Traces),结合强大的查询分析能力,提供对复杂分布式系统内部状态的深度理解。
- 云原生与Kubernetes监控成为标配: 工具对容器、Service Mesh、Serverless等云原生架构的监控支持更加成熟和自动化。
- 用户体验监控(RUM)与业务监控一体化: 将前端性能、用户行为与后端应用、基础设施指标关联,实现真正的端到端洞察。
- 安全监控融合: 基础设施监控数据与安全事件关联分析,提升威胁检测和响应能力。
服务器监控可视化工具已从简单的状态查看器,进化为驱动运维智能化、保障业务连续性的战略平台,其价值不仅在于故障发生后的快速响应,更在于通过持续的洞察、分析和优化,主动提升系统韧性、资源效率和用户体验,选择并实施好适合自身环境的监控可视化方案,是构建高效、稳定、可信赖的现代IT基础设施的基石。
您的监控体系是否真正支撑起了业务的稳定与增长?在服务器监控实践中,您遇到过哪些独特的挑战或拥有值得分享的高效经验?欢迎在评论区交流探讨!
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/14962.html





评论列表(3条)
这篇文章真让人眼前一亮!这些可视化工具就像给服务器装上了艺术的滤镜,让枯燥的运维数据瞬间生动起来。用过Grafana后,感觉工作效率飙升,强烈推荐给同行们试试!
这篇文章说得真对,服务器监控可视化工具确实是运维的命根子!作为搞技术的,我自己在项目里用过不少工具,比如Prometheus搭Grafana,实时图表把CPU、内存、网络这些数据一目了然呈现出来,问题还没爆发就能预警,省了好多熬夜救火的麻烦。不过,选工具得看实际需求:小团队用开源的很划算,像Zabbix上手快;大公司的话,Datadog这种付费的更省心,但成本高。缺点嘛,有些工具配置复杂,比如Prometheus得花时间折腾,新手容易头大。总之,监控不是摆设,关键要实时报警和易操作,否则数据堆成山也白搭。个人建议从简单的开始,别等系统崩了才后悔没早装!
监控工具选得好,运维少烦恼!文章说得太对了,可视化界面让服务器状态一目了然。我亲测Grafana搭配Prometheus超实用,实时性强、图表清晰,推荐大家试试看,提升效率杠杠的。