

现代数据中心运维的智能中枢
服务器监控大屏绝非简单的数据展示屏,它是保障业务连续性的核心神经中枢,其核心价值在于将海量、复杂的服务器及基础设施运行数据,转化为直观、实时、可行动的决策依据,让IT运维团队在问题影响用户前精准识别、快速响应,显著提升系统稳定性与运维效率。
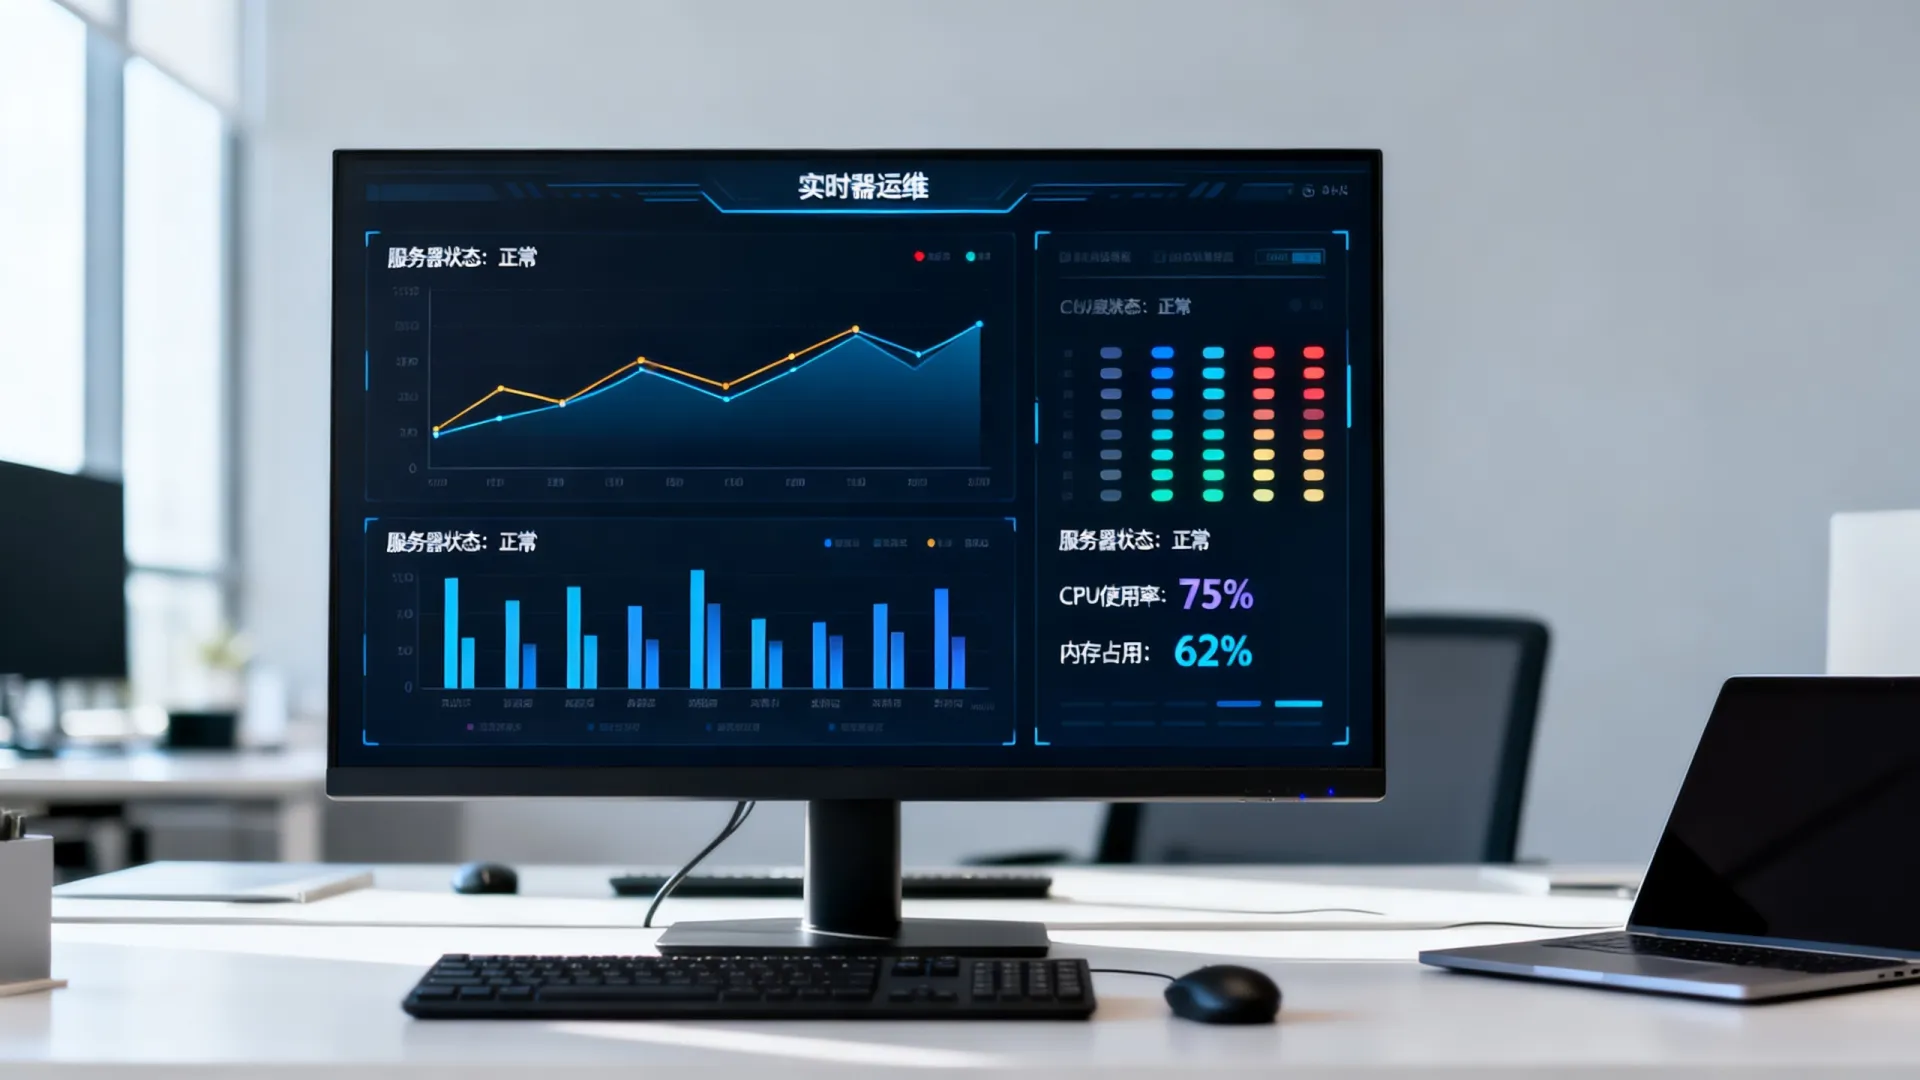
服务器监控大屏的核心价值与关键功能
-
全局态势,一目了然:
- 实时健康总览: 大屏首要呈现核心业务系统、关键服务器集群(如Web层、应用层、数据库层)的整体运行状态(正常、警告、严重),通过醒目的颜色编码(绿、黄、红)或状态图标,让运维人员瞬间掌握全局健康度。
- 核心指标聚合: 集中展示CPU总体使用率、内存占用率、网络总吞吐量、磁盘I/O总量、关键服务/进程存活状态等核心KPI,避免在分散的监控工具中迷失。
-
实时告警,精准定位:
- 动态告警流: 大屏实时滚动显示最新产生的告警事件,包含告警级别(紧急、严重、警告)、告警源(具体服务器IP/主机名、服务名)、告警内容(如CPU超阈值、磁盘空间不足、服务宕机)、发生时间,确保关键问题不被遗漏。
- 告警智能聚合: 对根因相关的告警进行智能关联与压制,减少告警风暴干扰,帮助运维人员聚焦核心故障点,避免在冗余信息中浪费时间。
-
深度钻取,根因分析:
- 多维度可视化: 利用丰富的图表(如折线图、柱状图、热力图、拓扑图)展示服务器性能指标的时序变化趋势、资源消耗分布(按机房、集群、业务线)、服务间调用链路与依赖关系。
- 穿透式分析: 支持从大屏聚合视图逐层下钻,快速定位到具体性能瓶颈的物理服务器、虚拟机、容器实例或应用代码模块,为根因分析提供强大可视化支持。
-
容量规划与预测:
- 历史趋势分析: 展示关键资源(CPU、内存、磁盘、网络带宽)的历史消耗曲线与增长趋势,为容量扩容、资源优化提供数据支撑。
- 智能预测: 结合机器学习算法,预测未来特定时间段内资源使用峰值或容量瓶颈风险点,实现主动式容量管理,避免业务增长带来的突发性资源不足。
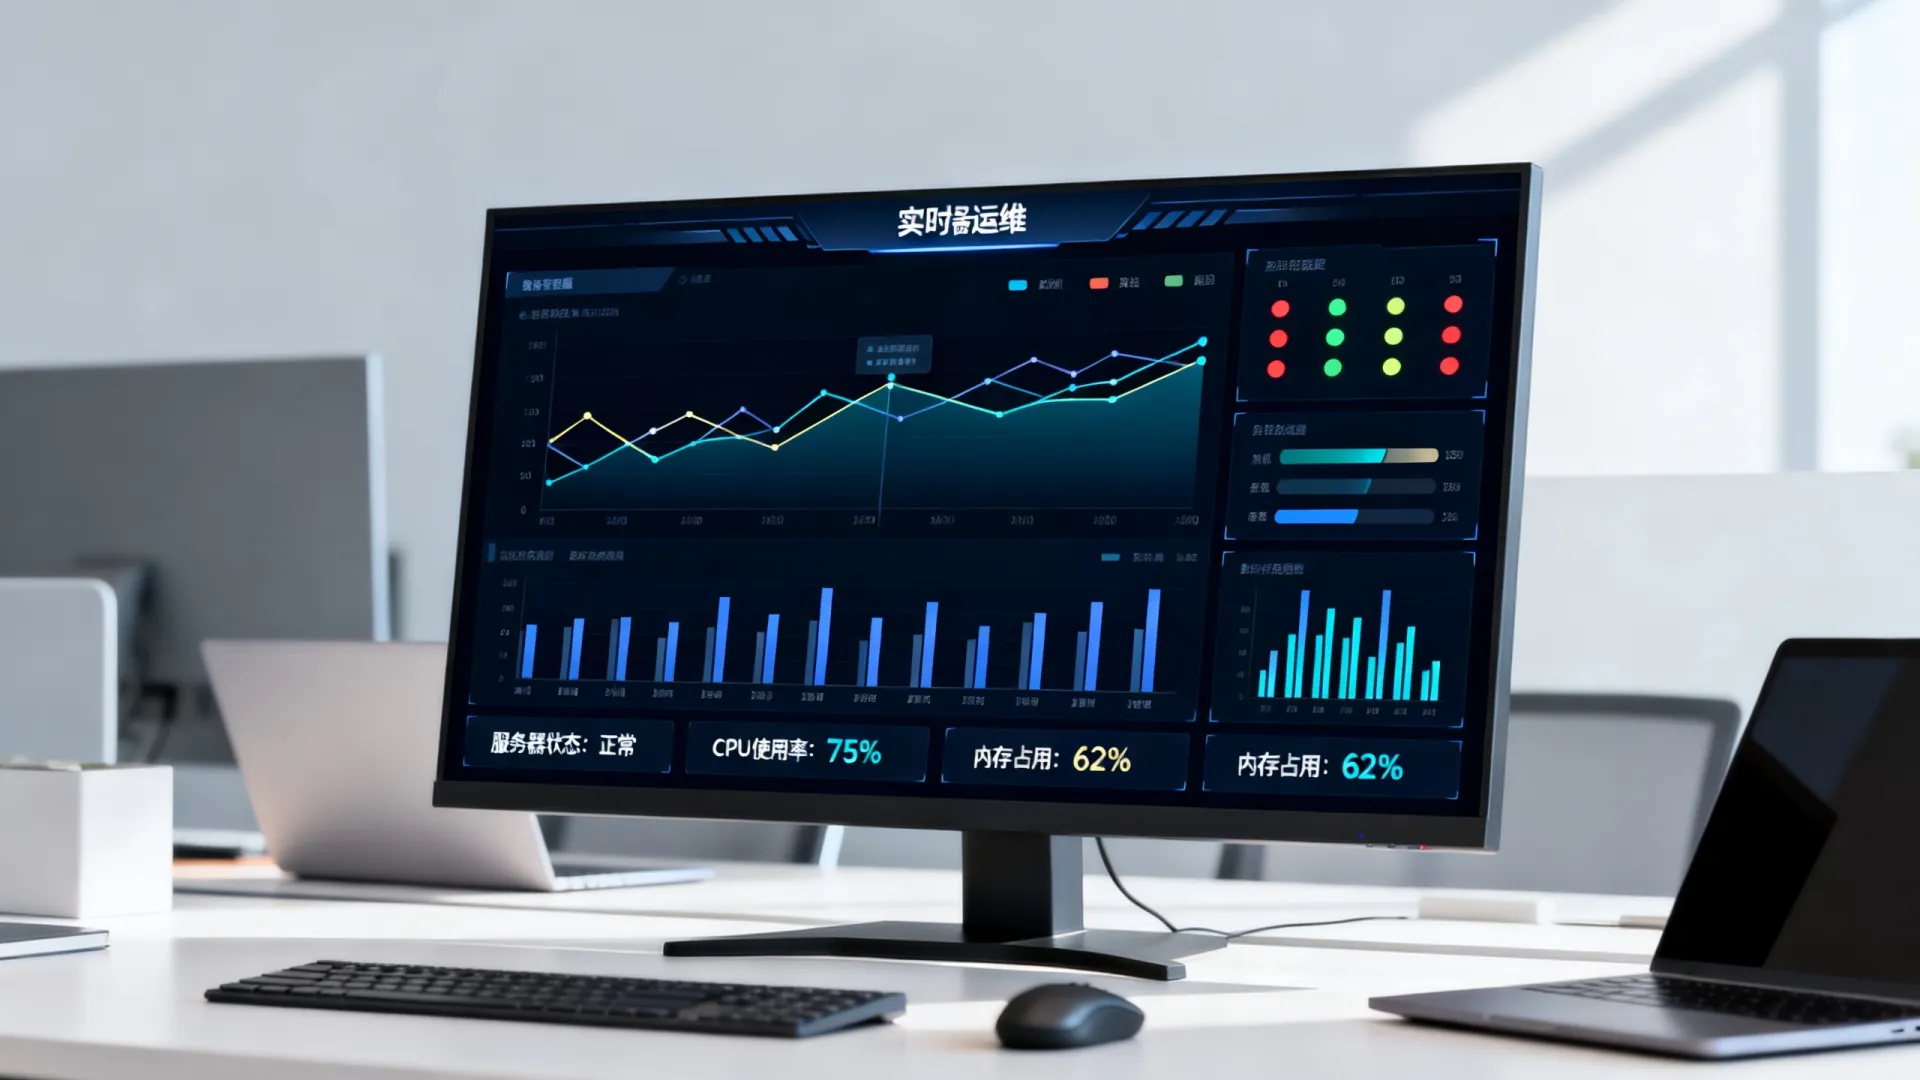
构建专业级监控大屏的技术方案
-
数据采集层:
- 代理模式: 在被监控服务器部署轻量级Agent(如Prometheus Node Exporter, Telegraf, Zabbix Agent),主动采集系统级指标(CPU、内存、磁盘、网络、进程)。
- 无代理模式: 通过SNMP、WMI、SSH/API等方式远程获取数据,适用于特定环境或无法安装Agent的场景。
- 应用级监控: 集成APM工具(如SkyWalking, Pinpoint, Elastic APM)采集应用性能指标(JVM、GC、慢SQL、接口响应时间、错误率)。
- 日志采集: 使用ELK Stack(Elasticsearch, Logstash, Kibana)或Loki+Promtail+Grafana方案,集中收集、索引和分析服务器日志,关联异常事件。
-
数据处理与存储层:
- 时序数据库: 核心选择,Prometheus(活跃生态,适合云原生)、InfluxDB(高性能写入)、TimescaleDB(基于PostgreSQL的时序扩展)是主流选择,高效存储和查询海量时间序列指标数据。
- 日志平台: Elasticsearch(强大的全文搜索与分析能力)或Loki(轻量级,Grafana原生集成)用于日志存储与分析。
- 消息队列: Kafka/Pulsar作为数据缓冲与管道,解耦采集端与消费端,应对流量洪峰。
-
可视化与告警层:
- 可视化引擎: Grafana 是业界构建监控大屏的绝对首选,其优势在于:
- 强大的数据源支持: 原生支持Prometheus, InfluxDB, Elasticsearch, Graphite, MySQL, PostgreSQL等数十种数据源。
- 灵活的仪表盘构建: 提供丰富多样的面板类型(Graph, Singlestat, Table, Heatmap, Alert list等),支持灵活拖拽和深度定制。
- 告警中枢: 内置强大的告警规则引擎,支持多条件、多阈值、多通知渠道(邮件、钉钉、企业微信、Slack、PagerDuty、Webhook等)配置,并能将告警状态直接展示在仪表盘上。
- 模板化与变量: 支持模板化仪表盘,利用变量实现动态内容过滤(如按机房、业务线筛选视图),一个仪表盘满足多场景需求。
- 备选方案: Kibana(与ELK Stack深度集成,日志分析强项),商业解决方案如Datadog, Dynatrace(一体化强,成本高)。
- 可视化引擎: Grafana 是业界构建监控大屏的绝对首选,其优势在于:
高效实施服务器监控大屏的关键步骤
-
明确核心需求与目标:
- 确定监控大屏的核心受众(运维团队、值班人员、管理层)及其最关注的信息。
- 识别关键业务系统、核心服务器集群及其必须监控的黄金指标(如电商系统的订单处理延迟、支付成功率;数据库的主从延迟、QPS/TPS)。
- 定义清晰的告警策略(阈值、升级机制、静默规则)。
-
精心设计可视化布局与信息层级:
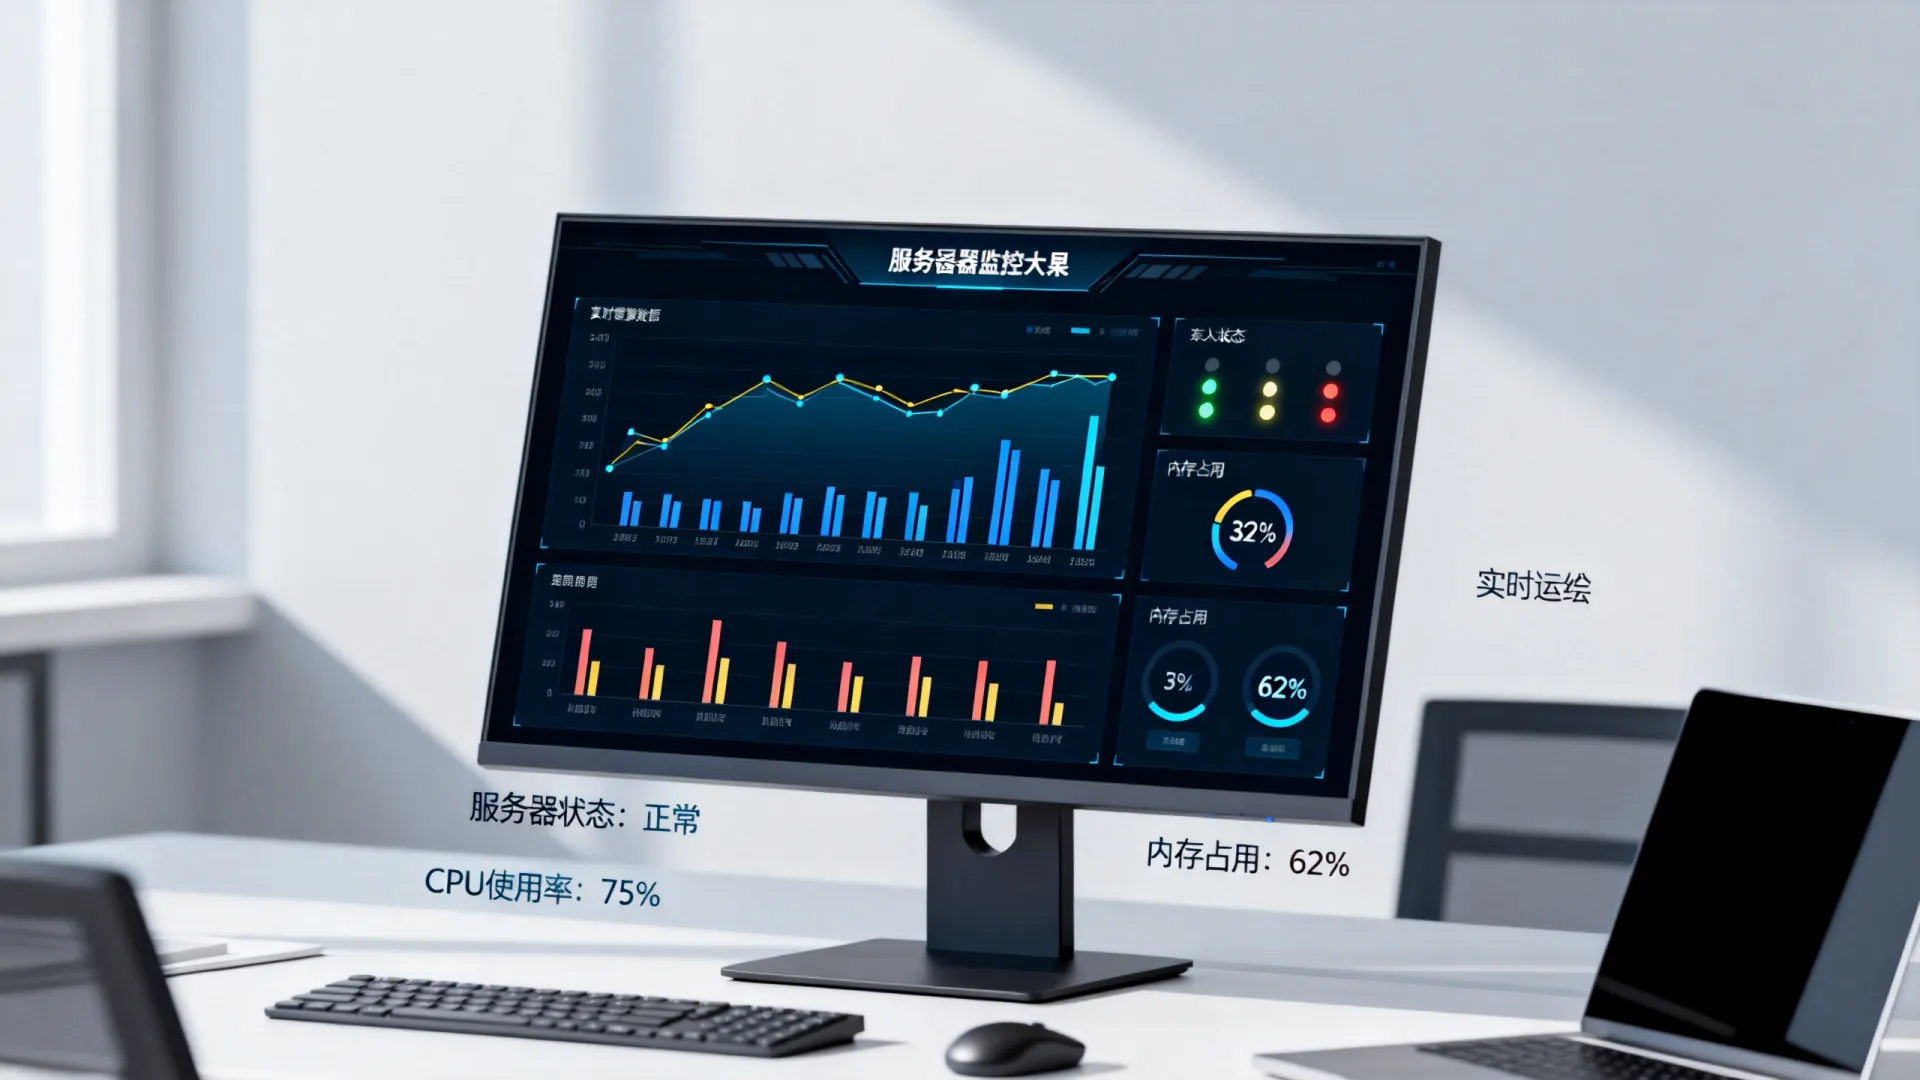
- 分区布局: 将大屏划分为逻辑清晰区域(如全局状态区、核心KPI区、实时告警区、资源趋势区、业务健康区、网络拓扑区)。
- 信息密度与焦点: 平衡信息丰富度与可读性,核心告警和关键状态必须醒目突出(位置、大小、颜色),避免图表过度拥挤。
- 色彩语义: 严格遵守颜色规范(如绿色=正常,黄色=警告,红色=严重/故障),确保信息传达无歧义。
-
严谨部署与持续优化:
- 分阶段部署: 优先上线核心业务和关键指标的监控,再逐步扩展覆盖范围和深度。
- 告警有效性验证: 定期测试告警规则是否能正确触发并及时送达,避免“狼来了”或“漏报”。
- 持续迭代: 定期收集用户(运维、开发、业务方)反馈,根据业务变化和技术演进调整监控指标、告警阈值和大屏视图。
- 性能保障: 监控数据采集、存储、查询、渲染各环节的性能,确保大屏数据刷新流畅,不影响被监控服务器性能。
未来趋势:智能化与深度融合
- AIOps深度集成: 监控大屏将不仅是数据展示窗口,更是AI驱动的运维决策入口,集成异常检测(自动发现偏离基线的指标)、根因分析建议、智能告警降噪与关联、预测性维护(预测磁盘故障、容量瓶颈)等功能。
- 可观测性统一平台: 深度融合指标(Metrics)、日志(Logs)、链路追踪(Traces)三大支柱数据,在大屏上实现从用户请求到后端服务、基础设施的端到端透明化观测与关联分析。
- 自动化闭环: 监控大屏将与自动化运维平台(如Ansible, SaltStack, Rundeck)联动,在识别严重故障时,自动触发预定义的修复剧本(如服务重启、节点隔离、流量切换),缩短故障恢复时间。
您的监控大屏现状如何?当前在实时掌握服务器状态、快速定位故障根源方面面临的最大挑战是什么?欢迎在评论区分享您的实践经验或遇到的难题,共同探讨优化之道!
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/13495.html




评论列表(3条)
看了这篇文章,深有同感!搞运维的都知道,一个直观好用的监控大屏真是团队的眼睛和大脑。文章说它是“智能中枢”一点不夸张,尤其是在半夜被报警叫醒的时候,能一眼看清问题在哪、影响多大,真是救命稻草。 作者强调把海量数据变成“可行动的决策依据”,这点我特别认同。我们团队以前也搞过一个监控屏,初期光顾着数据堆砌,图表酷炫是酷炫,结果关键信息反而被淹没了,值班同学该懵还是懵。后来吸取教训,重点就放在几个核心指标上:服务健康状态(红/绿)、关键业务流量、错误率、核心资源瓶颈(CPU、内存、磁盘、网络)。颜色区分、阈值告警一定要清晰显眼,页面刷新快慢也直接影响实用性。 文章点出了运维团队的痛点,但我觉得实操中更难的可能是数据源的整合和清洗。不同系统、不同时期的监控数据格式乱七八糟(比如老设备、云服务、自研系统),怎么把它们统一、关联起来,形成有意义的视图,这块真要花不少力气,选对工具和做好数据治理是关键。另外,告警的收敛和通知策略也得和大屏配合好,不然大屏红了,告警风暴也来了,人还是抓瞎。 总之,文章方向是对的,搭建大屏的核心目标就是让团队快速理解系统状态、减少判断时间。别追求太花哨,实用、稳定、信息密度高才是王道。真想搞一个的话,重点考虑清楚:团队最关心什么指标?出了问题第一眼最需要看到什么?搞清楚了这些,再选技术栈,会靠谱很多。运维兄弟们已经很苦了,搞个真正帮他们省力的大屏吧!
作为一个错误码收藏家,这监控大屏真实用!实时显示错误码,帮我快速定位问题,运维效率飙升。
@甜程序员5504:是啊,监控大屏实时显示错误码确实很实用!不过我在想,错误码多了会不会让屏幕太乱,影响快速定位?或者有些误报需要手动过滤?